
動かせなくても、動いてはいた — 2021年12月 us-east-1障害に学ぶコントロールプレーンとデータプレーンの分離
2021年12月7日にus-east-1で発生したAWSの大規模障害を、AWS公式のポストイベントサマリーの記載だけを材料に整理します。内部ネットワークとメインネットワークを繋ぐデバイスの輻輳により制御系APIが広範に停止する一方、稼働中のEC2インスタンスやS3・DynamoDBへの直接アクセスは影響を受けませんでした。この非対称性を自分のシステムの設計点検にどう落とすかまでを扱います。
- #AWS障害
- #us-east-1
- #コントロールプレーン
- #可用性設計
- #SRE
2021年12月7日、AWSの北バージニアリージョン(US-EAST-1)で大規模な障害が発生しました。マネジメントコンソールにログインできず、EC2インスタンスを起動できず、ECSのタスクを入れ替えることもできない——それが朝から夕方まで続いた一方で、そのとき既に動いていたEC2インスタンスは動き続け、S3やDynamoDBへの直接アクセスも通っていました。AWSが公開しているポストイベントサマリーには、この「止まったもの」と「動き続けたもの」の線引きが明記されています。
この記事は、AWS公式サマリーに書かれている事実だけを材料に、何が起きたのか、なぜ影響がこう分かれたのか、この非対称性を設計点検にどう落とすかを整理します。対象は、EC2・ECS・EKSをマルチAZで設計している設計者・SREの読者です。
前提 — 「制御する経路」と「データが流れる経路」
先に用語を整理しておきます。既にご存知の方は次の節まで読み飛ばしてください。
システムには、リソースを作る・消す・設定を変えるといった管理操作を担う経路と、実際の利用者リクエストが処理されるデータが流れる経路があります。前者をコントロールプレーン、後者をデータプレーンと呼びます。AWSに引き付けて言えば、EC2インスタンスを起動するAPIコールはコントロールプレーン、そのインスタンスの上で動くWebアプリケーションが受けるHTTPリクエストはデータプレーンです。この2つは実装上まったく違う経路をたどることがあり、今回の障害はそれが表に出た事例でした。
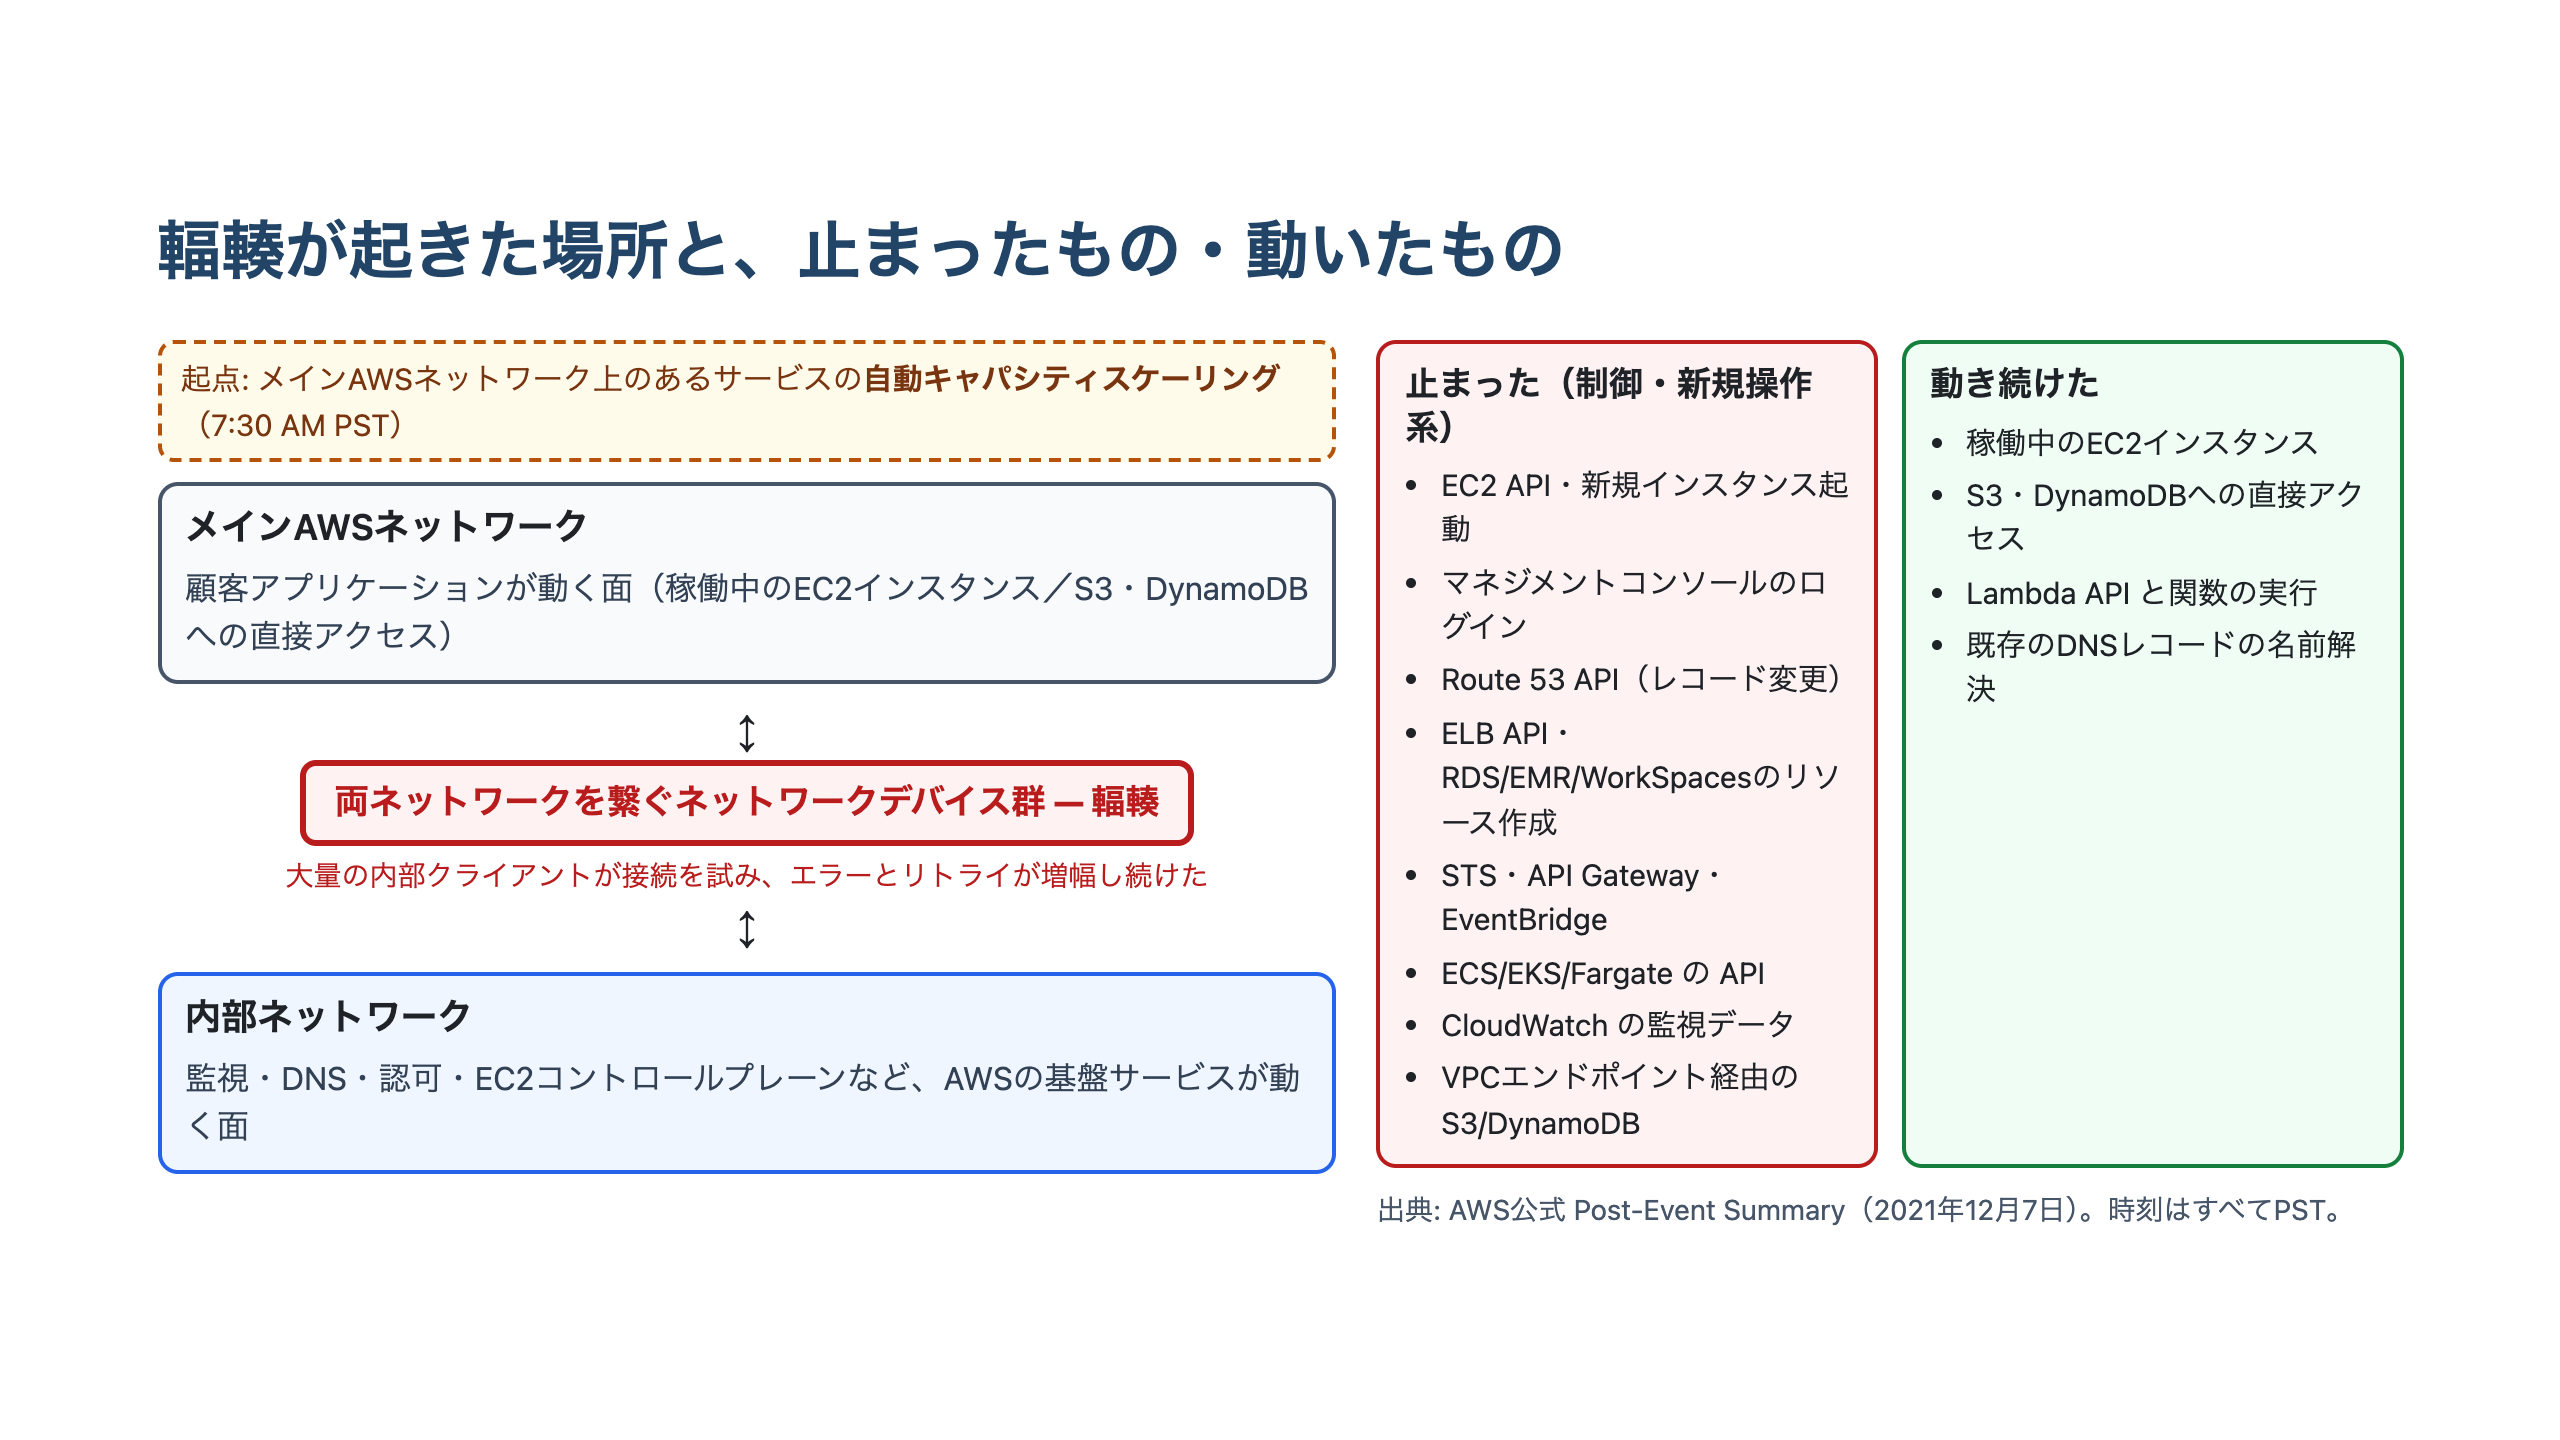
AWS公式サマリーの説明によれば、AWSは大きく2つのネットワークを運用しています。ひとつは顧客のアプリケーションが動くメインAWSネットワーク、もうひとつは、監視・DNS・認可・EC2のコントロールプレーンといったAWS自身の基盤サービスをホストする内部ネットワークです。この2つはネットワークデバイスを介して接続されており、内部ネットワークの側からメインネットワーク上のサービスへ、あるいはその逆へ、通信が行き来する構成になっています。
何が起きたか — 2021年12月7日の時系列
AWS公式のポストイベントサマリーによると、発端は 7:30 AM PST でした。メインAWSネットワーク上でホストされているあるサービスに対して、キャパシティをスケールさせる自動化された処理が走り、これが内部ネットワーク内の多数のクライアントから想定外の挙動を引き起こしました。大量の接続試行が一気に発生し、内部ネットワークとメインネットワークを繋ぐネットワークデバイス群が処理しきれなくなります。
ここから先が長引いた理由も、サマリーに書かれています。デバイスの輻輳によって両ネットワーク間の通信に遅延が生じ、遅延はエラーを生み、エラーはクライアント側のリトライを呼び、リトライがさらに輻輳を悪化させる——という増幅のループが成立してしまい、この状態が数時間にわたって持続しました。加えて、AWS自身の監視も内部ネットワークに依存していたため、状況の把握自体が難しくなっていたとAWSは説明しています。
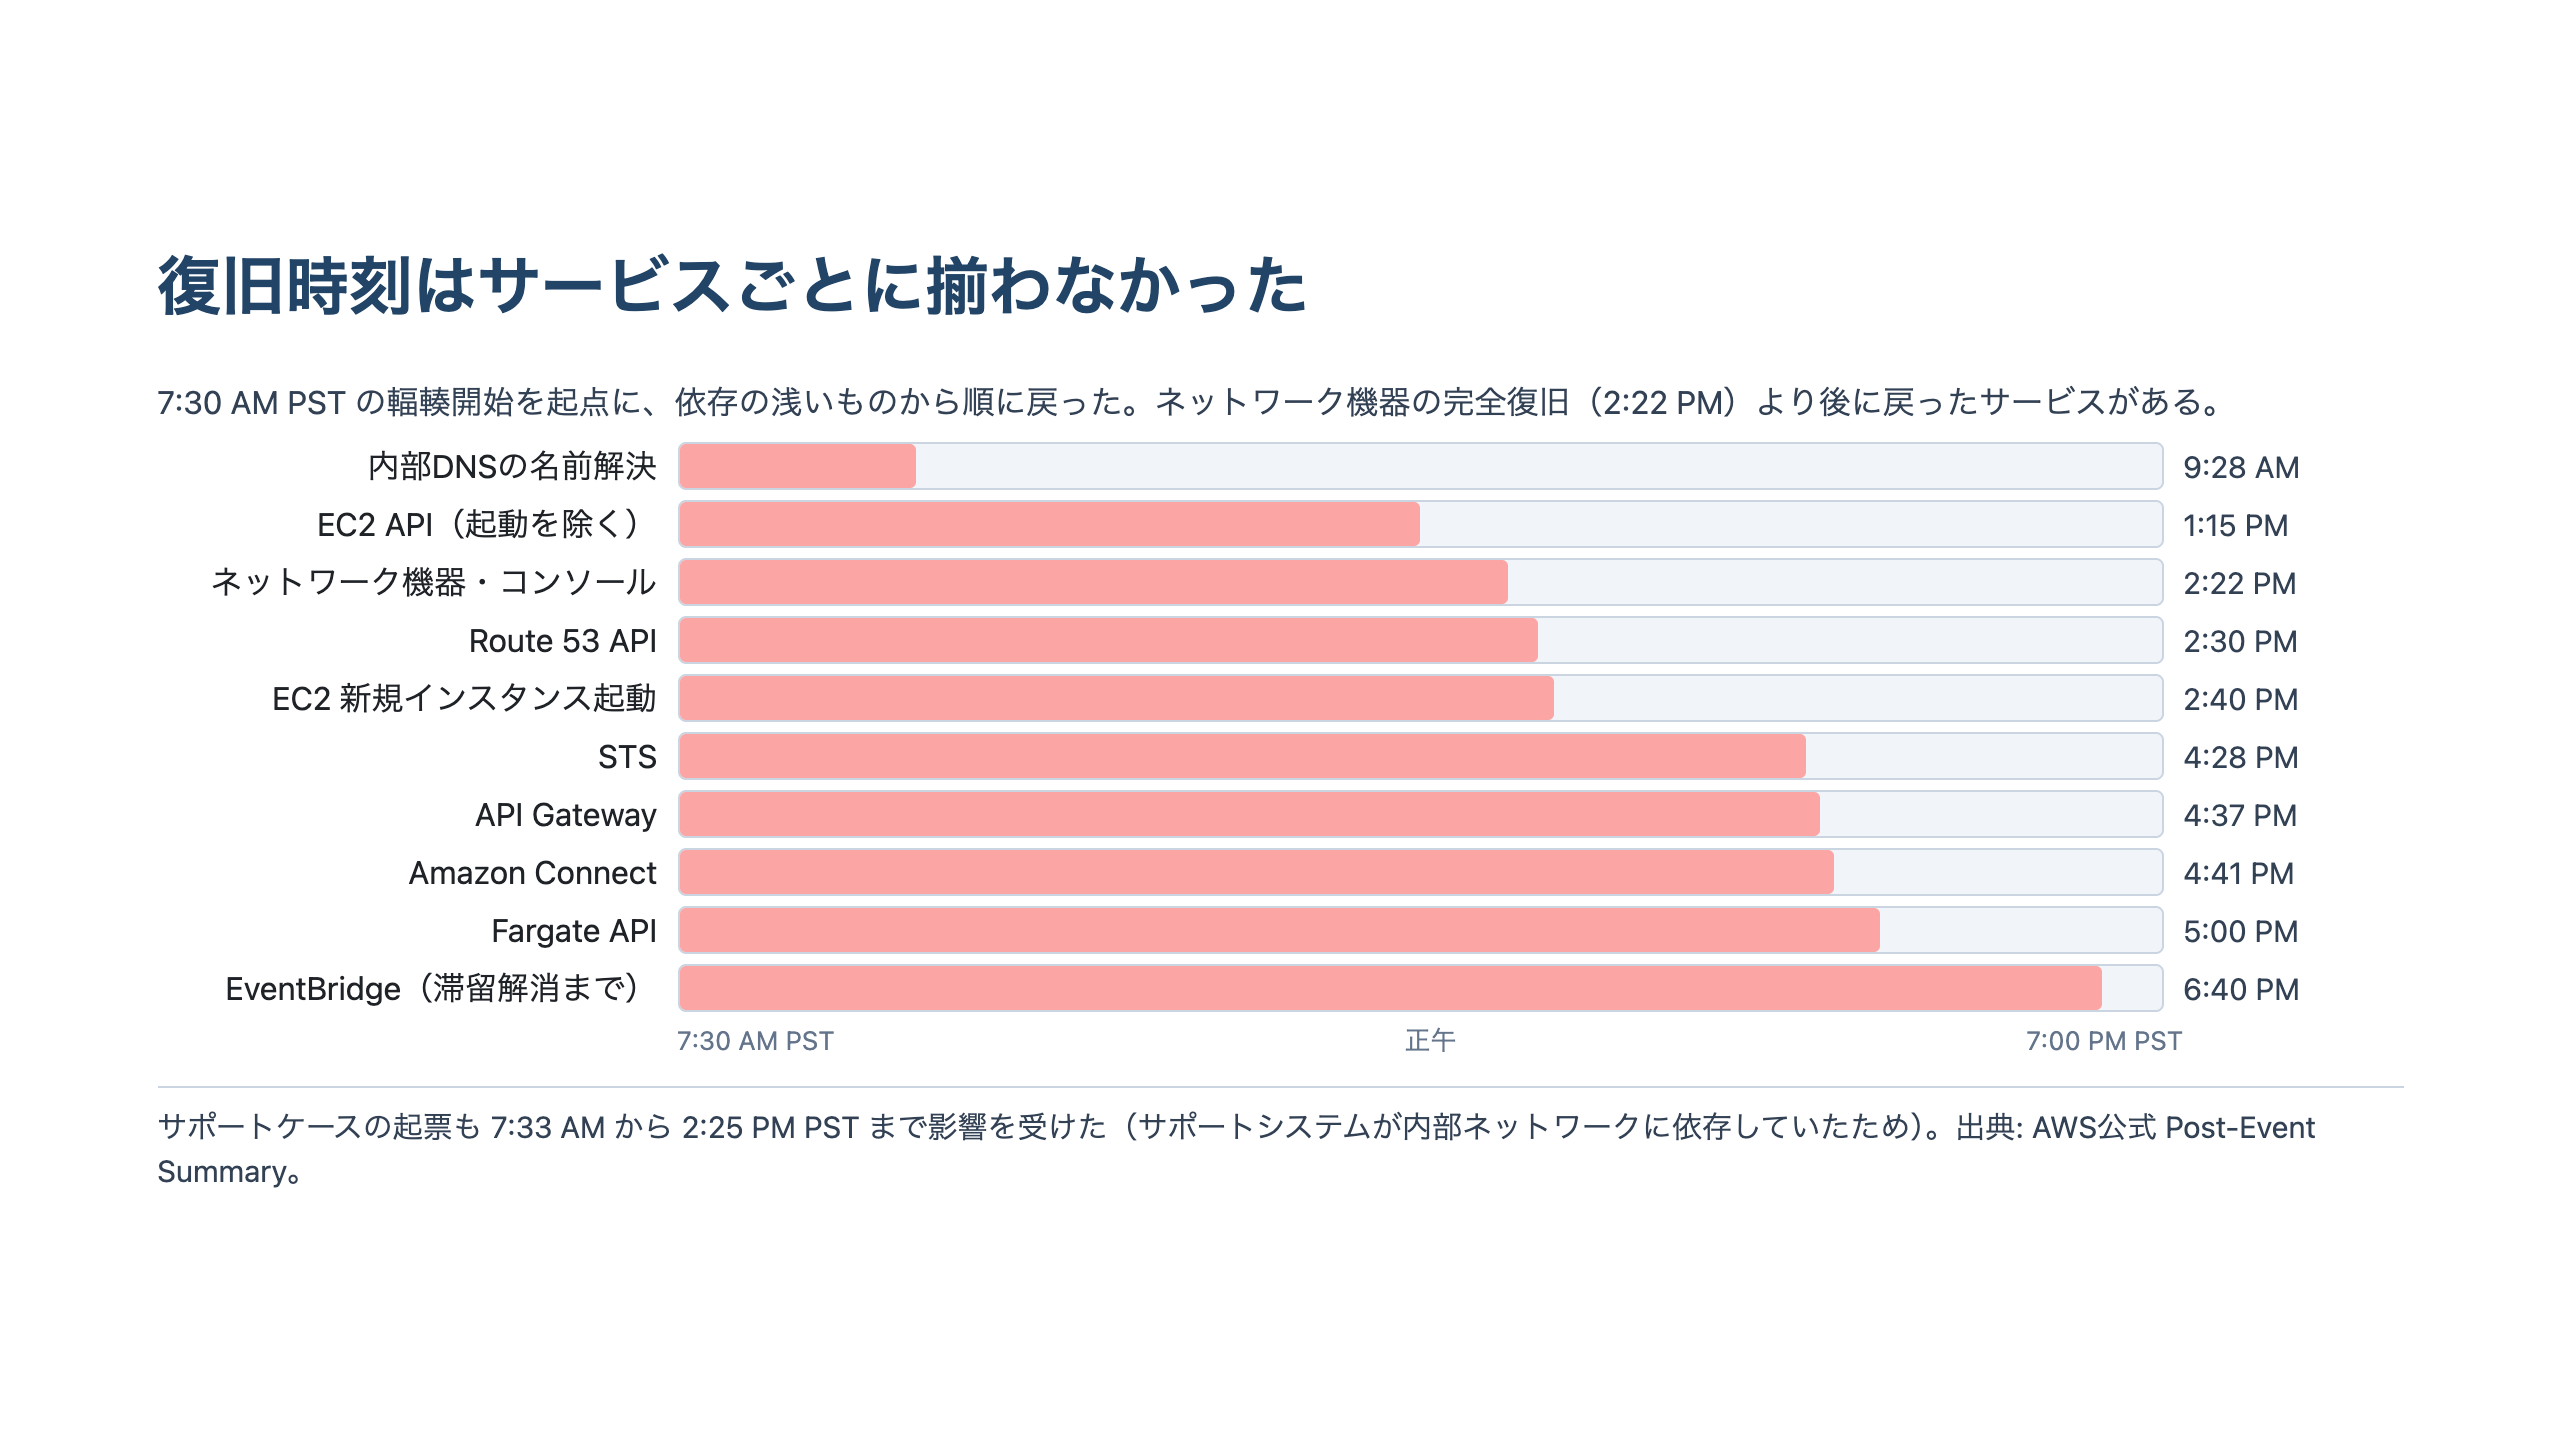
主要な時刻は次のとおりです(すべてPST。サービス別の復旧時刻は後述の図2)。
| 時刻 | 出来事 |
|---|---|
| 7:30 AM | 自動キャパシティスケーリング処理が内部クライアントの想定外の挙動を誘発、輻輳が始まる |
| 7:33 AM | EC2 APIのエラー率・レイテンシが上昇。サポートケースの起票も不可に(2:25 PM まで) |
| 8:22 AM | Service Health Dashboard に本障害の更新が入り始める |
| 9:28 AM | 内部DNSトラフィックの迂回作業が完了し、DNS解決エラーが完全復旧 |
| 12:35 PM | EventBridge のイベント配信を運用側が意図的に無効化(2:35 PM に再有効化) |
| 1:15 PM | EC2 APIのエラー率・レイテンシが改善開始(新規インスタンス起動を除く) |
| 1:34 PM | 輻輳が大幅に改善。1:35 PM にコンテナ関連APIの大半が正常化 |
| 2:22 PM | 全ネットワークデバイスが完全復旧、コンソールアクセスが完全復元 |
| 6:40 PM | 最後まで残った EventBridge の滞留処理が終わりレイテンシが正常化 |
止まったものと、動き続けたもの
影響を受けたサービスは広範でした。EC2 APIは新規インスタンスの起動も既存インスタンスの照会もエラーになり、RDS・EMR・WorkSpaces は新しいリソースを作成できなくなりました。Elastic Load Balancing はプロビジョニングが遅延し、Route 53 APIはDNSエントリの変更を受け付けなくなりました。マネジメントコンソールへのログインも失敗しています。
さらに、STS が OpenID Connect 経由でレイテンシ上昇、Redshift でログイン失敗、CloudWatch では監視の遅延と一部データの欠損が発生しました。Fargate・ECS・EKS はAPIがエラーを返し、コンテナの再起動に失敗するケースが生じています。Amazon Connect では通話・チャット・タスクの失敗率が上がりました。
一方で、AWSが明記している「影響を受けなかったもの」があります。
| 分類 | 内容 |
|---|---|
| 影響を受けなかった | 稼働中のEC2インスタンス/S3・DynamoDBへの直接アクセス/Lambda APIと関数の実行 |
| 影響を受けた | 上記の各種API・新規リソース作成・コンソールログイン/VPCエンドポイント経由でのS3バケット・DynamoDBテーブルへのアクセス |
注意したいのは最後の行です。S3とDynamoDBは「直接アクセスなら影響なし」ですが、VPCエンドポイント経由でのアクセスは影響を受けたとAWSは明記しています。同じサービスでも、どの経路を通るかで結果が変わりました。
復旧時刻が揃わなかったことの意味
もうひとつ読み取れる事実があります。復旧時刻がサービスごとにばらばらだったことです。
ネットワークデバイス自体が完全復旧したのは 2:22 PM PST ですが、STS の完全復旧は 4:28 PM、API Gateway の大部分の復旧は 4:37 PM、EventBridge のレイテンシ正常化は 6:40 PM でした。原因の解消から2時間〜4時間以上あとということになります。輻輳中に積み上がった処理の滞留を解消する時間に加え、各サービスが内部ネットワーク上の基盤サービスにどれだけ深く依存しているかの差が、復旧順に現れたものと読めます。障害の「終わり」は、原因の解消時刻ではなく、依存の一番深いところが戻った時刻です。
設計論 — 自分のシステムで何を点検するか
この障害の事実関係から、自分のシステムに当てはめて点検できる論点は3つあります。
1. 障害時の復旧手順が、コントロールプレーンに依存していないか。稼働中のEC2インスタンスは動き続けた一方、新規インスタンスの起動は 2:40 PM PST まで戻らず、ECS・EKSのAPIもエラーを返していました。つまり「インスタンスを入れ替える」「Auto Scalingで台数を増やす」「タスクを再デプロイする」といった対処は、この時間帯には実行できません。復旧手順書が起動系のAPIを前提にしているなら、それが使えない時間帯があり得ることを織り込む必要があります。
2. 認証・認可への依存が、どこまで広がっているか。STS の完全復旧は 4:28 PM PST で、ネットワーク復旧から2時間以上あとでした。一時的な認証情報を都度取得する設計では、STSの応答遅延がそのままアプリケーションの遅延やエラーになります。どのコンポーネントがどの頻度で認証情報を取り直し、失敗したときにどうなるかは点検の対象です。
3. 同じデータストアへの経路が、単一になっていないか。S3とDynamoDBは直接アクセスなら影響を受けず、VPCエンドポイント経由では影響を受けました。VPCエンドポイントの利用にはセキュリティ上の理由がありますが、この障害では経路の選択がそのまま可否を分けています。自分の構成がどの経路を通っているかの把握自体が、障害時の切り分けを早くします。
なお、AWSは事後対応として、トリガーとなったスケーリング処理を直ちに無効化し、クライアント側のバックオフ挙動の修正と、同種の事象でデバイスを保護する追加のネットワーク設定を展開したと説明しています。あわせて、新しいService Health Dashboard と複数リージョンで稼働するサポートシステムの提供方針も示しています。
まとめ
- 2021年12月7日のus-east-1障害は、7:30 AM PST に始まった内部ネットワークとメインネットワーク間のデバイス輻輳が原因で、エラーとリトライの増幅ループが長時間化を招きました。デバイスの完全復旧は 2:22 PM PST です。
- 影響は制御系・新規操作系に集中し、稼働中のEC2インスタンス、S3・DynamoDBへの直接アクセス、Lambdaの実行は影響を受けていません。ただしVPCエンドポイント経由のS3・DynamoDBアクセスは影響を受けました。
- 復旧時刻はサービスごとに揃わず、STSは 4:28 PM、EventBridgeのレイテンシ正常化は 6:40 PM でした。点検すべきは、復旧手順が起動系APIに依存していないか、認証情報の再取得への依存がどこまで広がっているか、データストアへの経路が単一になっていないか、の3点です。