
単一セルの容量閾値を越えた先 — 2023年6月 Lambda基盤障害に学ぶ依存関係の可視化
2023年6月13日のUS-EAST-1 Lambda障害(公式ポストイベントサマリー準拠)を題材に、Lambda Frontendフリートが単一セル内で未到達の容量閾値を超えたことが、なぜSTS・マネジメントコンソール・Connect・EventBridge・EKSにまで及んだかを整理します。セルを「テスト済みの規模」に収める設計原則と、マネージド依存の可視化・縮退設計を扱います。
- #AWS障害
- #US-EAST-1
- #AWS Lambda
- #Amazon STS
- #セルベースアーキテクチャ
- #可用性設計
- #SRE
- #サーバーレス
マネージドサービスは、可用性の確保をAWS側に委ねられる点が利点です。そのぶん依存先は見えにくくなります。2023年6月13日、AWS米国東部(US-EAST-1、バージニア北部)リージョンでLambdaに障害が発生しました。特徴的だったのは、引き金が故障でも攻撃でもなくトラフィック増加への通常のキャパシティ追加だったこと、そして影響がLambdaを直接使っていない操作にまで及んだことです。本記事は公式ポストイベントサマリーの記載だけを手がかりに、この事象を依存関係の可視化という観点から読み解きます。記載のない原因・影響規模は推測しません。
① 何が起きたか — 時系列
公式サマリーが挙げている主要な時刻は次のとおりです。表記は公式に合わせて太平洋夏時間(PDT)のままとし、日本時間はPDTに16時間を加えた時刻になります。
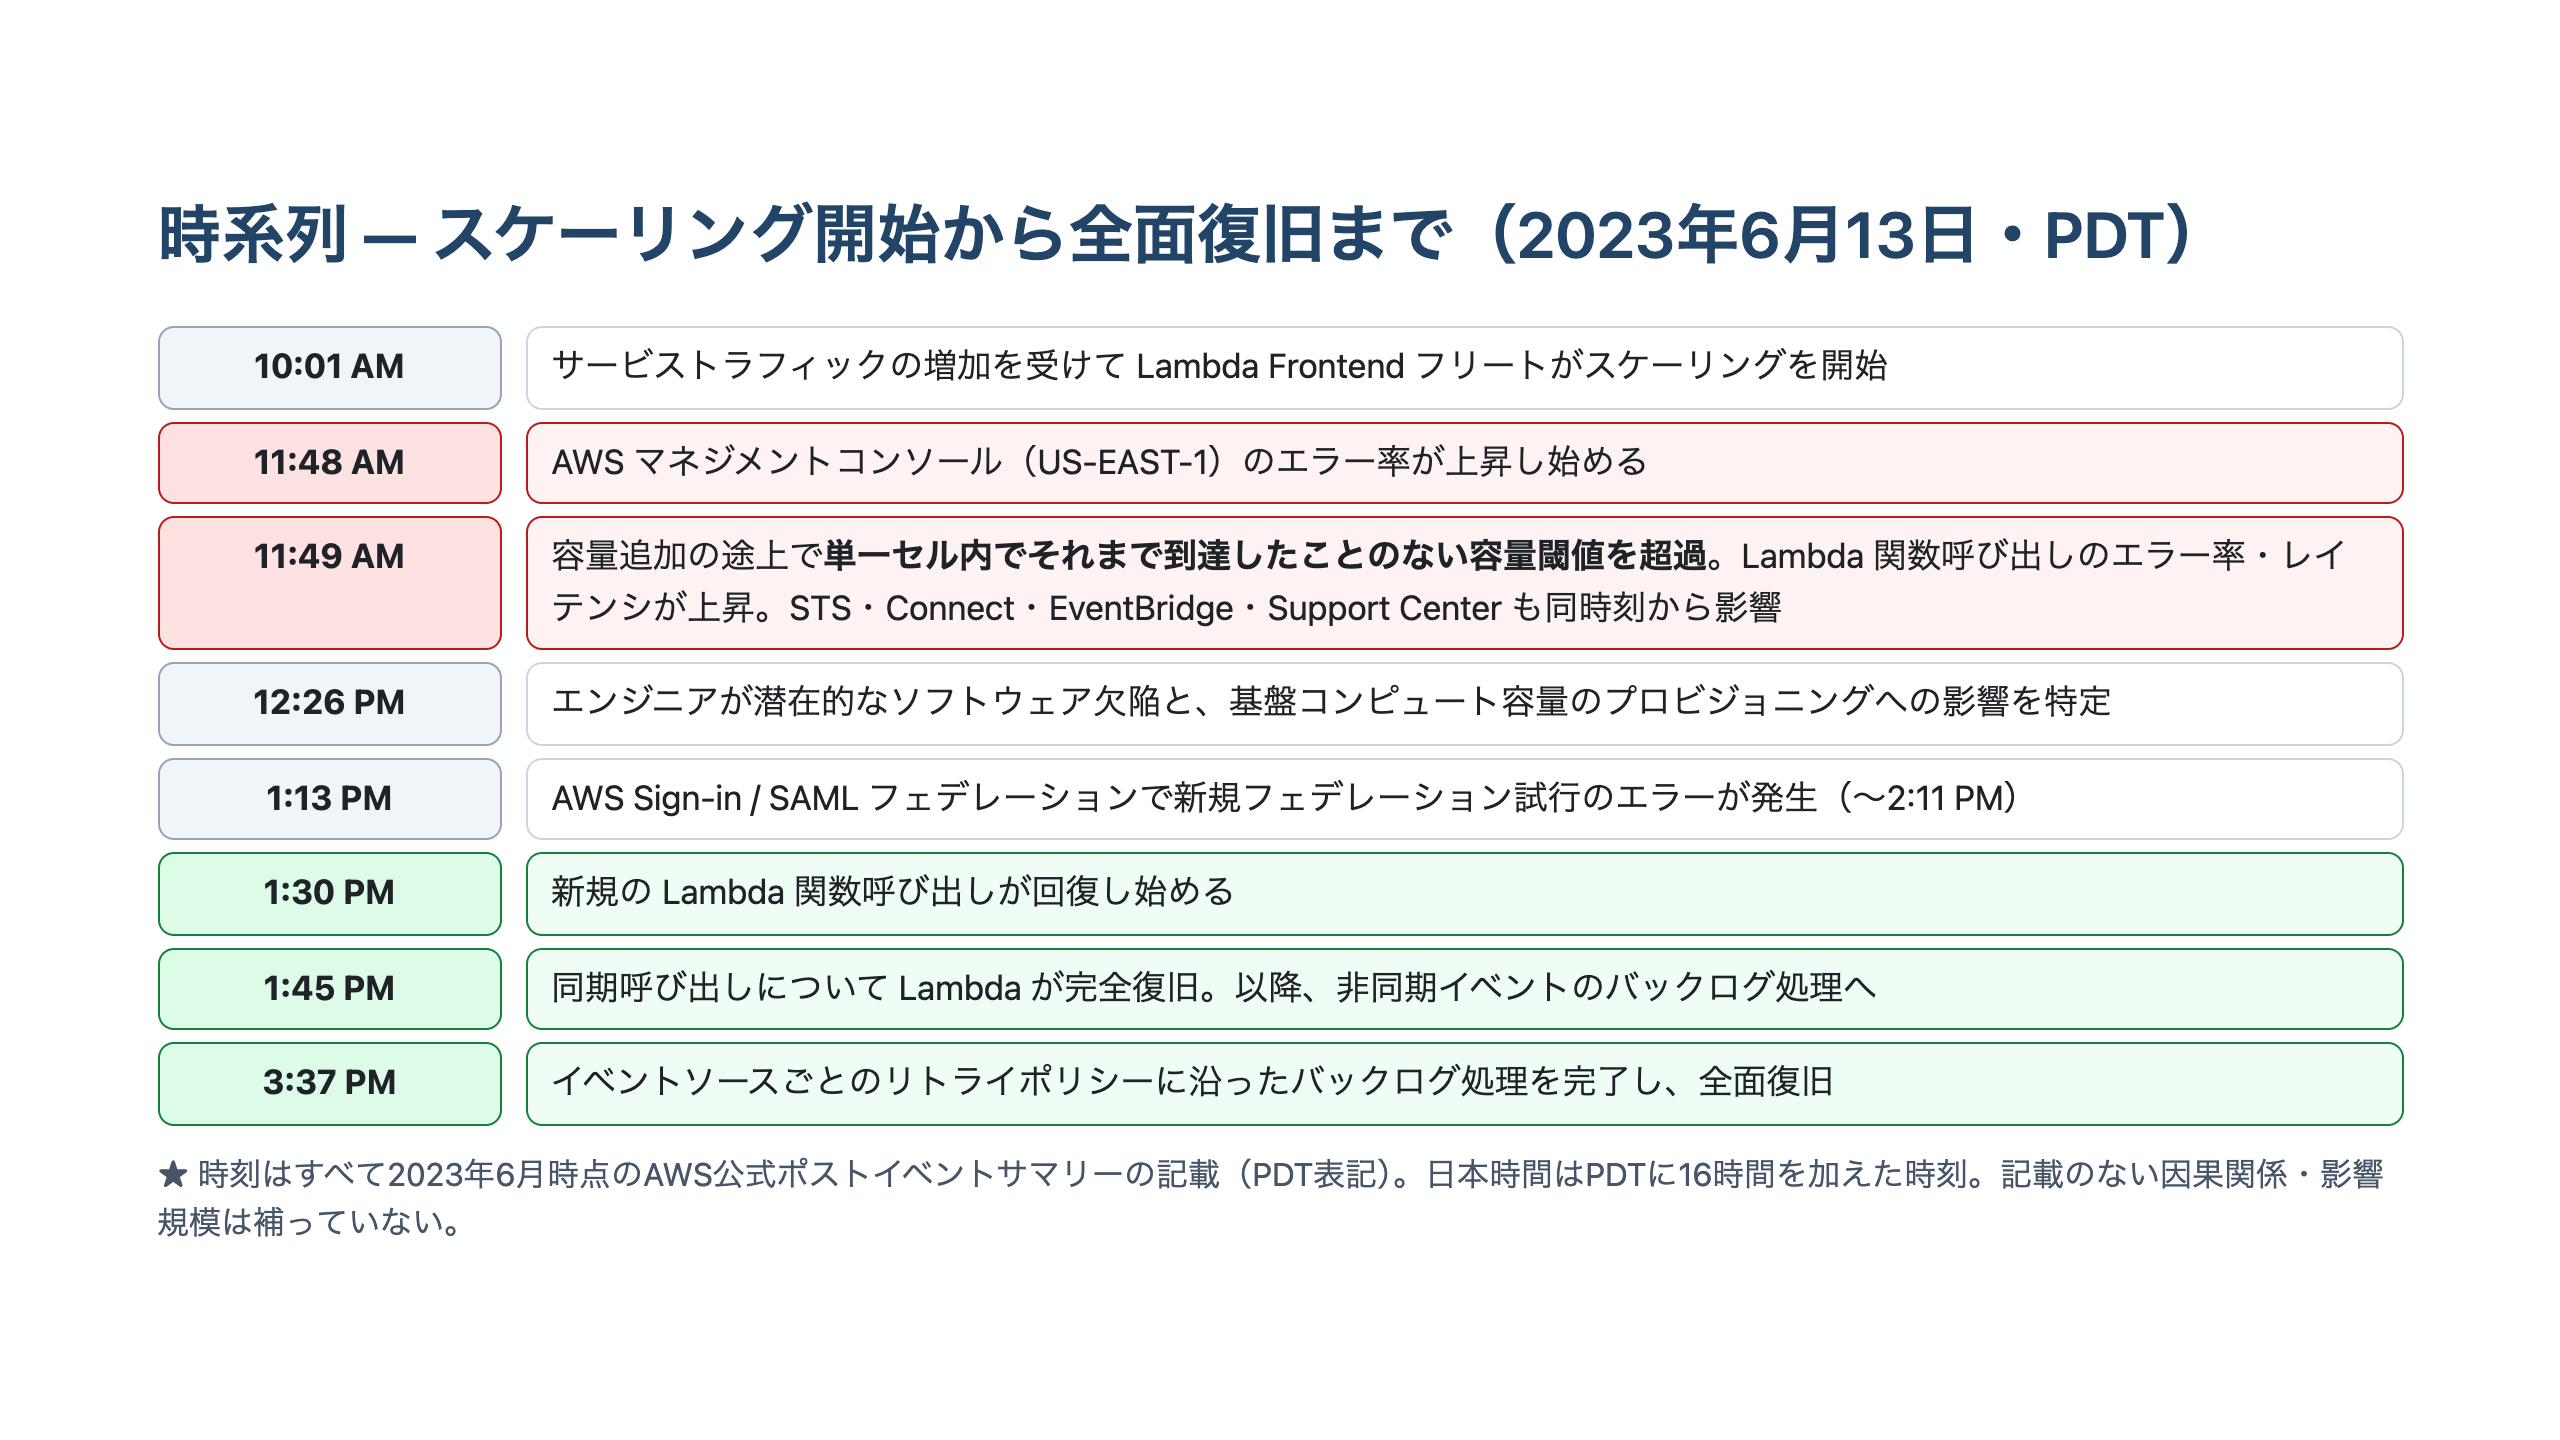
起点は10:01 AM、サービストラフィックの増加を受けLambda Frontendフリートがスケーリングを開始した時点です。異常が表面化したのは11:49 AMで、Lambda関数呼び出しのエラー率とレイテンシ(応答にかかる時間)が上昇し始めました。12:26 PMにエンジニアが潜在的なソフトウェア欠陥と、基盤コンピュート容量のプロビジョニングへの影響を特定しています。
回復は段階的でした。1:30 PMに新規のLambda関数呼び出しが回復し始め、1:45 PMに同期呼び出しが完全復旧。以降は各イベントソースのリトライポリシーに沿って非同期イベントのバックログを処理し、3:37 PMに全面復旧しました。異常の表面化から全面復旧まで、およそ3時間48分の事象です。
同期呼び出しの復旧(1:45 PM)から全面復旧(3:37 PM)までは約1時間52分の開きがあり、呼び出し経路の復旧後も非同期イベントを捌き切るまで事象は続きます。
② 影響はどこまで広がったか
公式サマリーが影響を記載しているサービスと時間帯は次のとおりです。
| サービス | 公式記載の影響 | 影響時間帯(PDT) |
|---|---|---|
| AWS Lambda | 関数呼び出しのエラー率・レイテンシの上昇 | 11:49 AM〜3:37 PM |
| Amazon STS | エラー率の上昇(3つの明確な影響期間) | 11:49 AM〜2:10 PM |
| AWS Sign-in / SAMLフェデレーション | 新規のフェデレーション試行でエラー | 1:13 PM〜2:11 PM |
| AWSマネジメントコンソール(US-EAST-1) | エラー率の上昇 | 11:48 AM〜2:02 PM |
| Amazon Connect | コンタクト処理の機能低下 | 11:49 AM〜1:40 PM |
| Amazon EventBridge | 最大801秒の配信遅延 | 11:49 AM〜1:45 PM |
| Amazon EKS | 新規クラスタのプロビジョニングでエラー率・レイテンシ増(既存クラスタは影響なし) | 11:49 AM〜1:45 PM |
| AWS Support Center | 機能低下 | 11:49 AM〜2:38 PM |
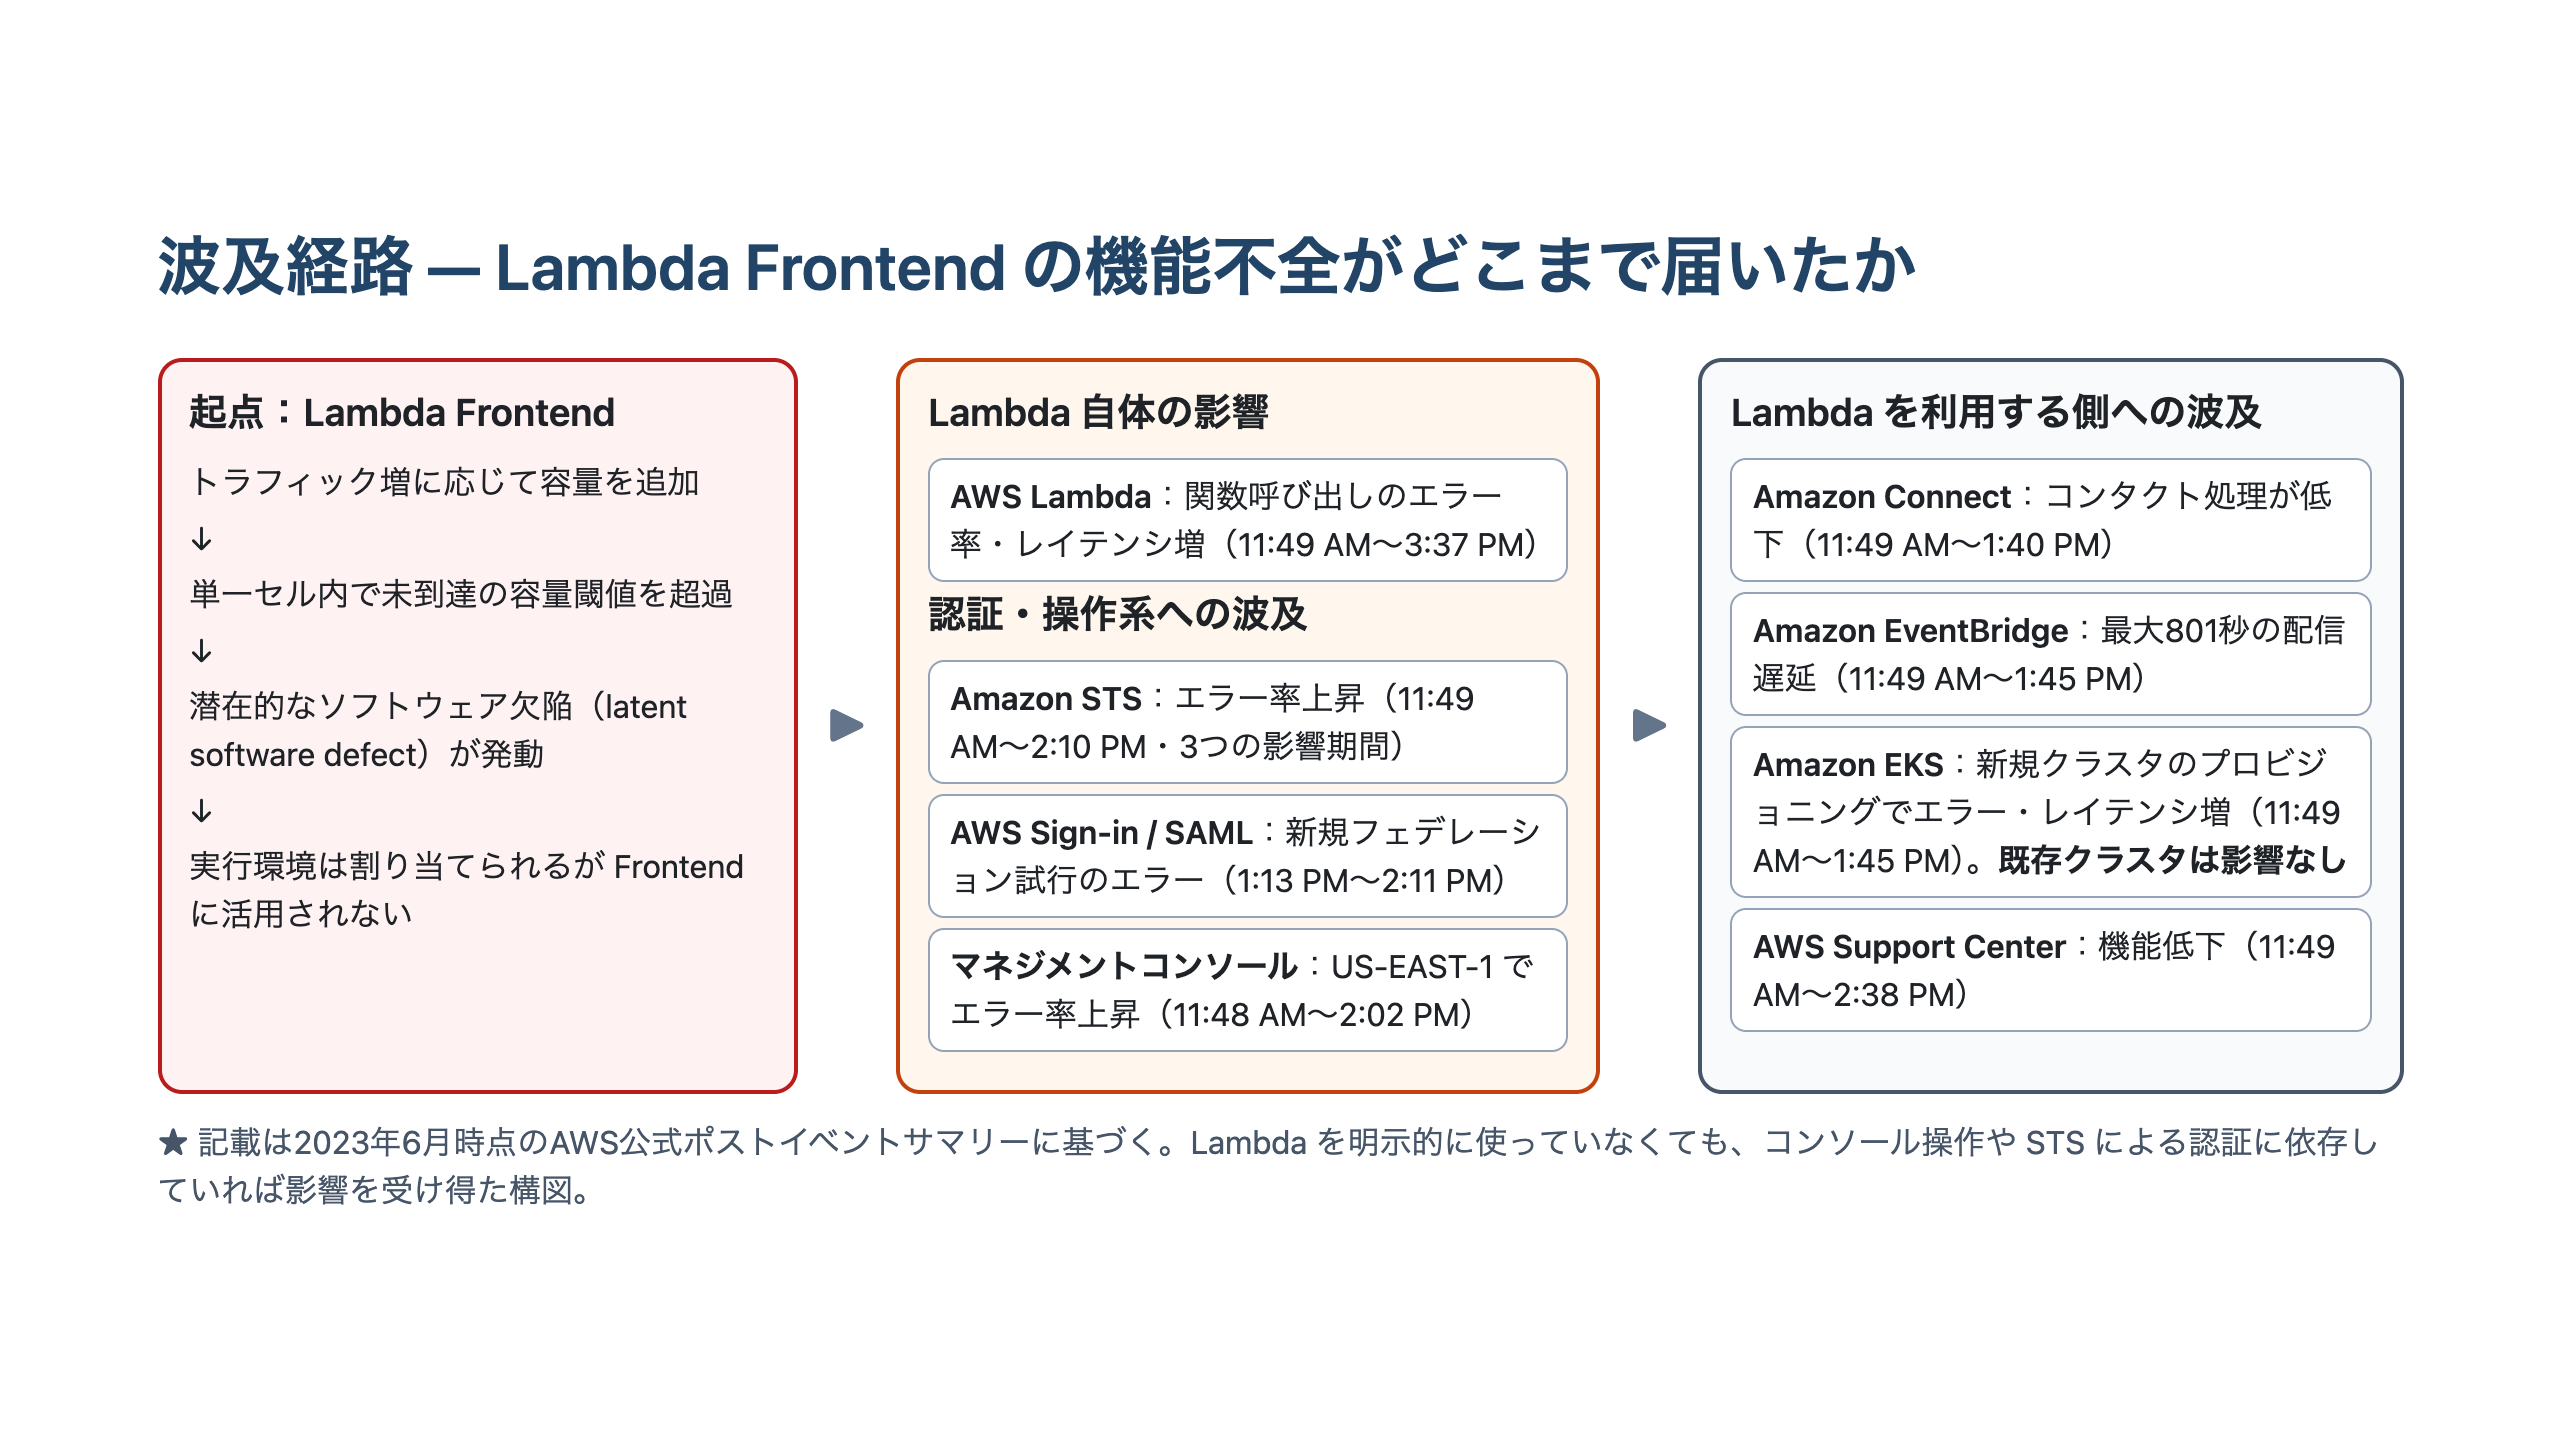
読みどころは2点です。第一に、Lambda関数を1つも作っていない利用者でも影響を受け得た構図です。マネジメントコンソールとSTSが影響を受けたため、コンソール操作や一時的な認証情報の取得に依存していればLambdaと無関係な作業でも詰まり、復旧作業自体がコンソール経由なら復旧も難しくなります。
第二に、EKSの記載です。新規クラスタのプロビジョニングはエラーが増えた一方、既存クラスタは影響を受けていません。「すでに動いているものは動き続け、新しく作る操作が止まる」という出方で、コントロールプレーン(作成・変更を受け付ける管理系)とデータプレーン(実行系)が分かれる構成の特徴を示します。
③ 公式が説明する原因 — 単一セル内で初めて超えた容量閾値
公式サマリーによれば、11:49 AMにLambda Frontendフリートは、増加したトラフィックへの計算資源追加の途中で、単一セル内でそれまで到達したことのない容量閾値を超えました。これが潜在的なソフトウェア欠陥を発動させ、着信リクエストに実行環境(Execution Environment)は正常に割り当てられるものの、Lambda Frontendがそれを十分に活用しない状態を招いたと説明されています。
見落としにくいのは、割り当てが失敗したのではなく、割り当てられた資源が使われなかった点です。個々の構成要素は「成功」を返しつつ、全体としては処理が進まない形になります。なぜ閾値の超過がこの欠陥を発動させたのか、内部構造は公式サマリーの記載を超えるため推測しません。
公式サマリーはAWS自身の対応も示しています。自環境の備えと混同しないよう分けて整理します(いずれも2023年6月時点の発表)。
- Lambda Frontendフリートのスケーリング動作を直ちに停止
- 原因となった潜在的な欠陥を修正し全リージョンへ展開(発表時点で完了済み)
- セルのスケーリングに関する当面の課題に対処(発表時点で複数完了済み)
- 予期しないスケーリング問題を避けるため、すべてのセルを十分にテスト済みの規模に収める取り組みを継続
④ 設計論その1 — セルは「テスト済みの規模」に収める
4点目の是正策にある「すべてのセルを十分にテストされた規模の範囲に収める」という表現は、AWS Well-Architectedが公開しているセルベースアーキテクチャのガイダンスと同じ発想に立っています。
同ガイダンスは、スケールアップ(構成要素そのものを大きくする)ではなくスケールアウト(構成要素の数を増やす)で成長に対応する利点を挙げています。ひとつは最大サイズを固定できることで、上限を設けることで線形でないスケーリング要因や隠れた競合箇所による予期しない事態のリスクを下げられます。もうひとつはテストできる大きさに収まることで、上限までの負荷をかけて安全な動作範囲を把握できます。
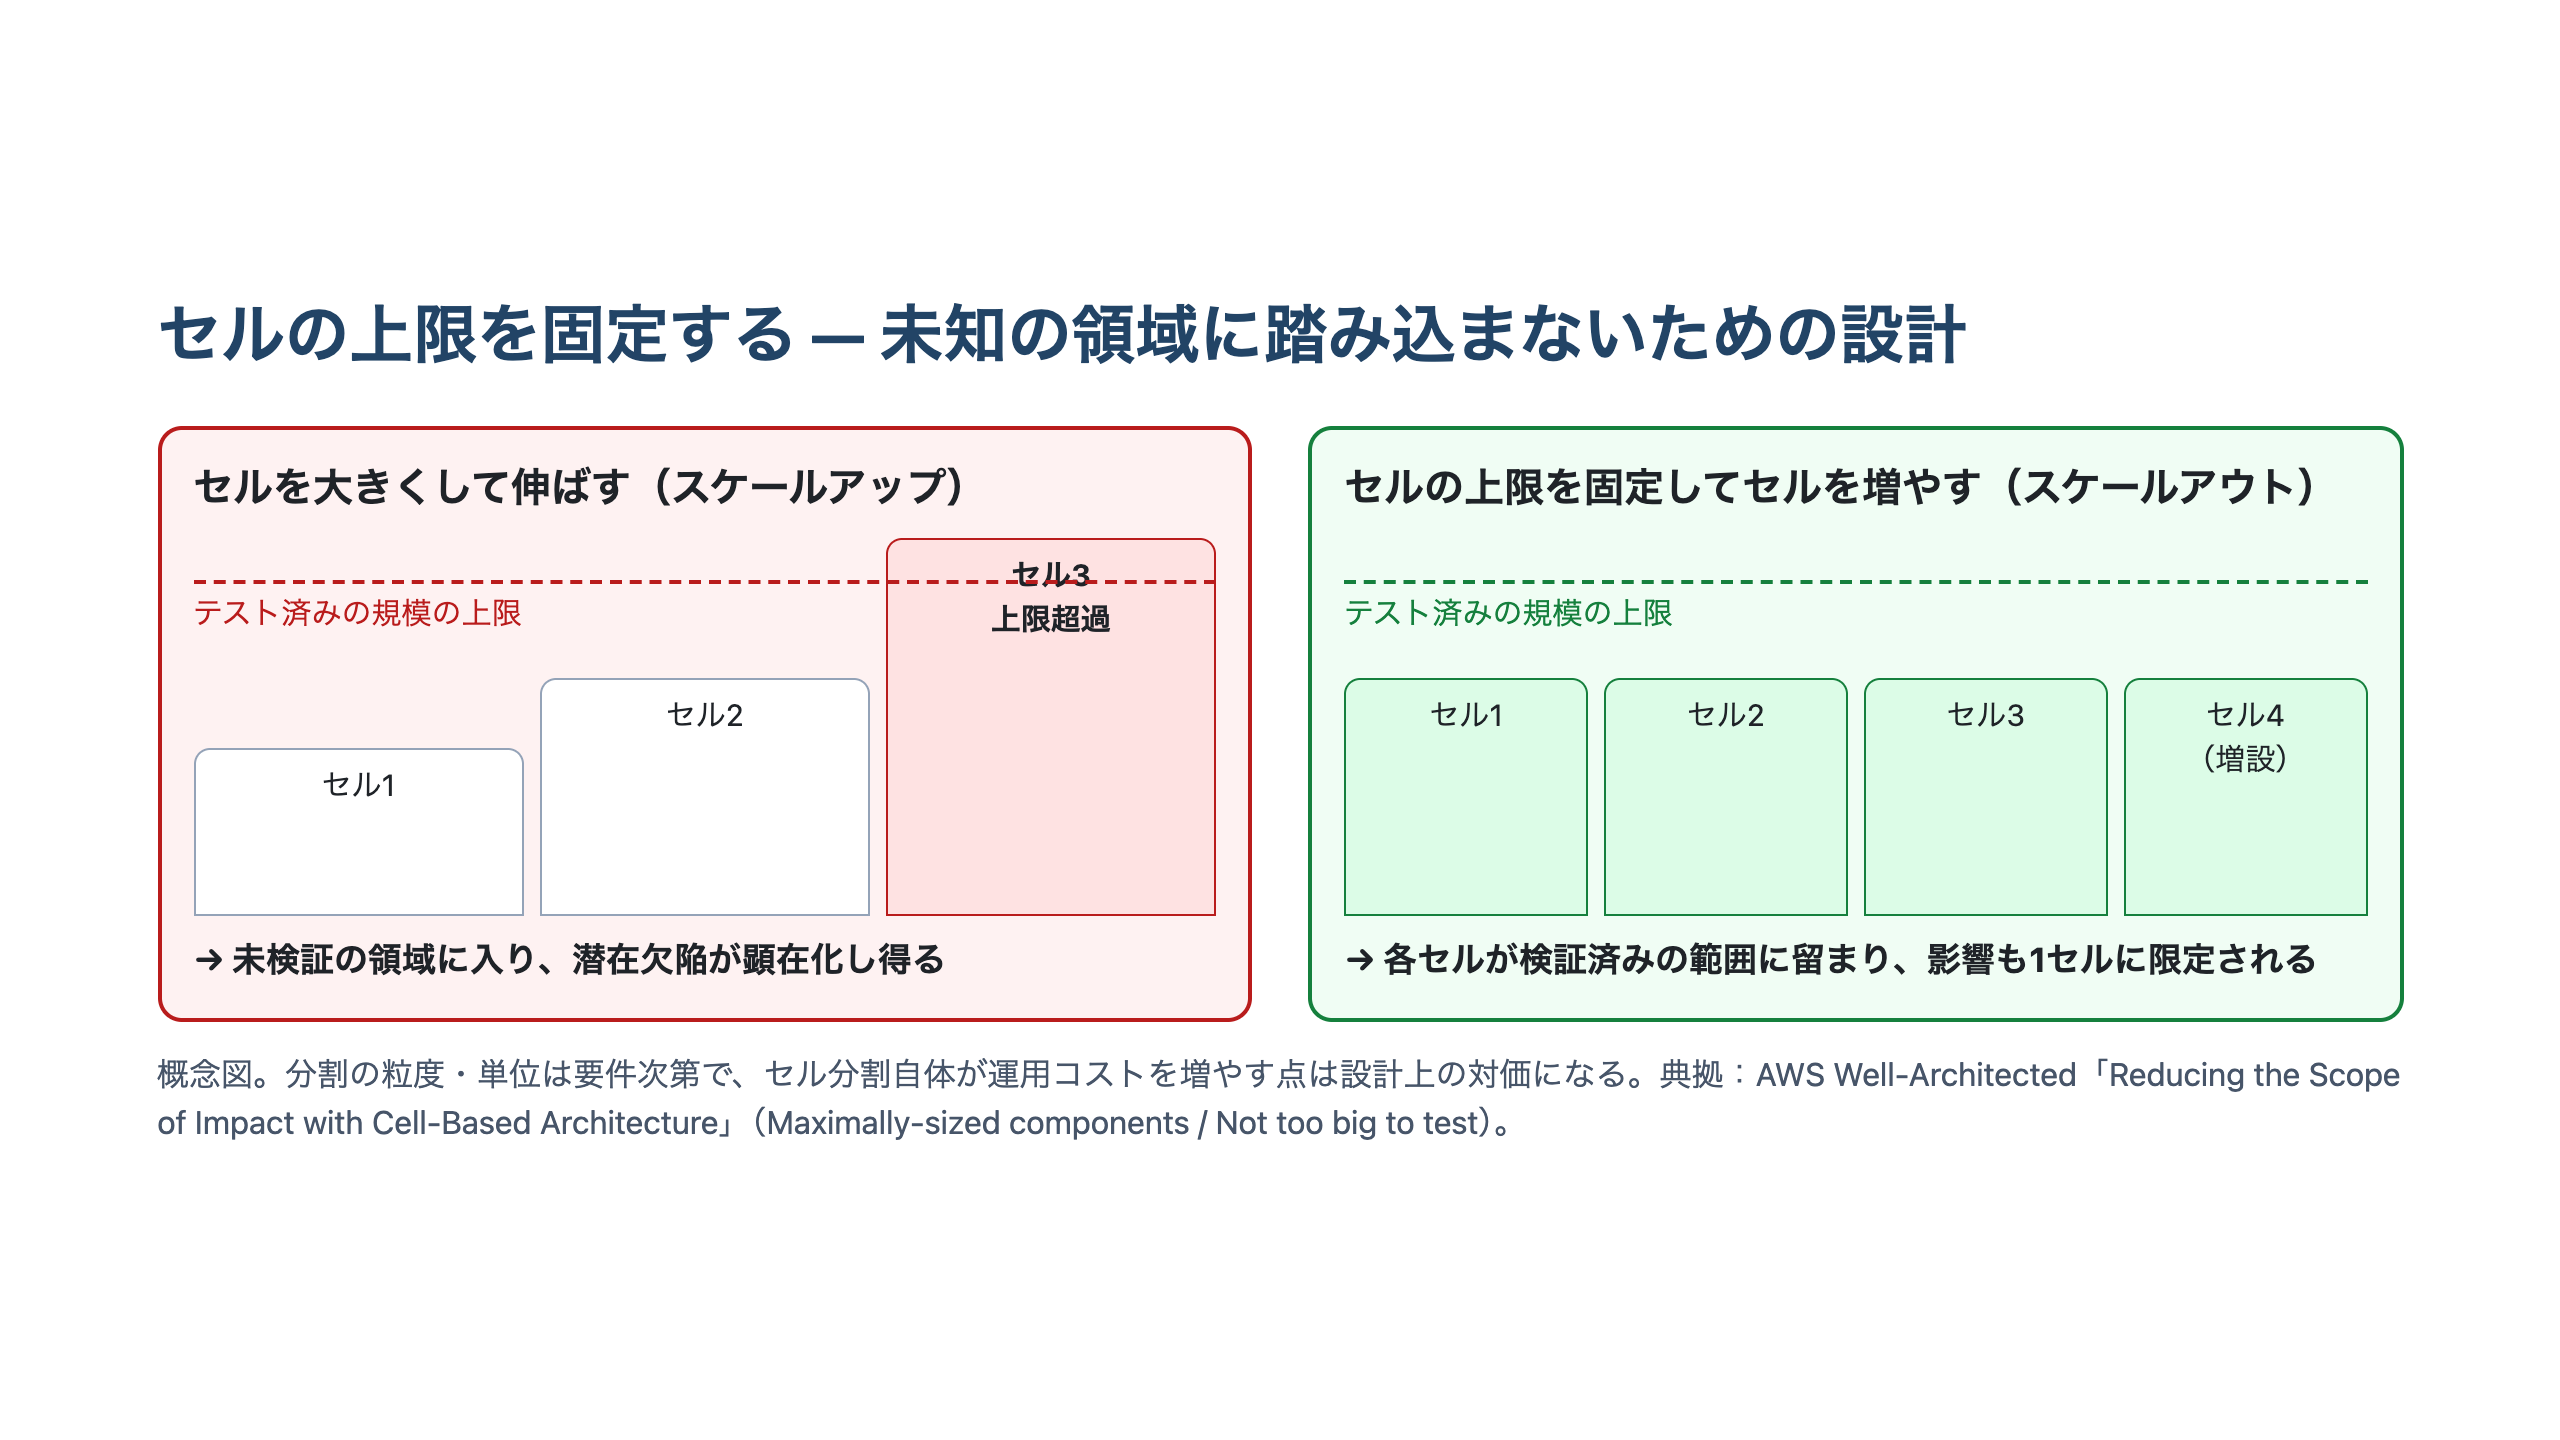
同ガイダンスはあわせて、影響範囲(スコープ・オブ・インパクト)の縮小も利点に挙げています。適切に分離されたセルどうしは、リージョン間と同程度の障害の封じ込めを持ち得るという説明です。
自システムでは「どこまでの規模で検証したか」の把握が点検対象です。負荷試験の確認範囲が目標値までなら、その先は未検証の領域です。目標値の何倍まで壊れずに動き、壊れるときどう壊れるかを掴んでおけば、増設の判断は「まだ大丈夫か」ではなく「検証済みの範囲か」で下せます。セル分割自体は運用対象を増やす選択でもあり、粒度は要件次第です。
⑤ 設計論その2 — マネージド依存の可視化と縮退動作
利用者側でLambda基盤の内部構造は変えられません。変えられるのは、依存先が応答しないときの自システムの振る舞いです。
第一に依存経路の洗い出しです。直接呼び出すサービスだけが依存先とは限りません。STSの一時的な認証情報を使っていればSTSも、EventBridge経由の非同期処理を組んでいれば最大801秒の配信遅延がそのまま自システムの遅延になり、運用手順がコンソール操作を前提にしていればコンソールも依存先に含まれます。
第二に、依存先が応答しないときの縮退動作(グレースフルデグラデーション。機能を全部止めず一部を落として動き続けること)です。非同期イベントが遅延したとき、主要機能まで止める設計か、通知や集計だけ遅らせて主要機能は続ける設計かは実装上の選択です。今回、同期呼び出し復旧から全面復旧までに時間差があった事実は、非同期経路の遅延がどれだけ続き得るかの参考になります。
第三に、リトライ設計です。再試行の回数・間隔と最終的な退避先(デッドレターキュー等)を決めておかないと、復旧後にイベントが失われるか、再試行の集中で復旧を妨げるかのどちらかに転びます。
⑥ 明日できる点検
ここまでの観点を、自環境で確認できる問いに落とします。
| 観点 | 点検する問い |
|---|---|
| 依存経路の可視化 | 直接呼び出すサービス以外に、認証・イベント連携・運用手順を通じた依存先を洗い出しているか |
| 検証済みの規模 | 負荷試験で確認した上限が、目標値ではなく「壊れ始める点」として把握できているか |
| 増設時の前提 | キャパシティ追加が、検証済みの範囲内で行われる構成になっているか |
| 縮退動作 | 非同期経路の遅延・失敗時に、主要機能が止まらず動き続ける設計になっているか |
| リトライと退避 | 再試行の回数・間隔と、諦めたイベントの退避先が定義されているか |
| 運用経路の独立 | 障害時の復旧手順が、影響を受け得る同じコンソール・同じリージョンだけに依存していないか |
まとめ
2023年6月のLambda障害からの論点は3つです。第一に、引き金は通常のキャパシティ追加で、限界に当たったのは単一セル内の未到達の容量閾値だったこと。第二に、影響がLambdaを直接使っていない認証・コンソール操作にまで及び、依存の広がりが利用者から見えにくいこと。第三に、AWS自身の是正策が「すべてのセルを十分にテストされた規模に収める」方向を向き、Well-Architectedのセル設計原則と重なることです。
いずれも障害を完全に防ぐ施策ではなく、影響を局所化し依存先が応答しないときも動き続ける範囲を確保する設計判断です。本記事は2023年6月時点の事象を扱っており、AWSはその後是正策を講じています。適用前に公式の最新情報を確認してください。