
DNSレコードが空になった日 — 2025年10月 DynamoDB障害に学ぶ自動化の排他制御
2025年10月19日から20日にかけてのUS-EAST-1 DynamoDB障害(公式ポストイベントサマリー準拠)を題材に、DNS PlannerとDNS Enactorのあいだで成立した競合状態がリージョナルエンドポイントのDNSレコードを空にした経緯を原文の記述に沿って追い、独立に動くアクターの排他制御と、単一エンドポイント依存が届く範囲という2つの設計論点を整理します。
- #AWS障害
- #US-EAST-1
- #Amazon DynamoDB
- #DNS
- #競合状態
- #信頼性設計
- #SRE
サービス自体は動いていても、名前解決ができなければ全体が止まります。2025年10月19日から20日にかけてAWS米国東部(US-EAST-1、バージニア北部)リージョンで発生した障害は、その形を取りました。起点はDynamoDBのDNS管理を担う自動化に潜んでいた競合状態(複数の処理が同時に走ったときのタイミング上の欠陥)で、リージョナルエンドポイントのDNSレコードが空になり、自動化がそれを修復できませんでした。本記事はAWS公式のポストイベントサマリーの記載だけを手がかりに整理し、記載のない事柄は推測しません。
① 何が起きたか — 時系列
事象は2025年10月19日 11:48 PM PDTに始まり、10月20日 2:20 PM PDTに終了しました。時刻は公式に合わせて太平洋夏時間(PDT)で表記します(日本時間は16時間後)。
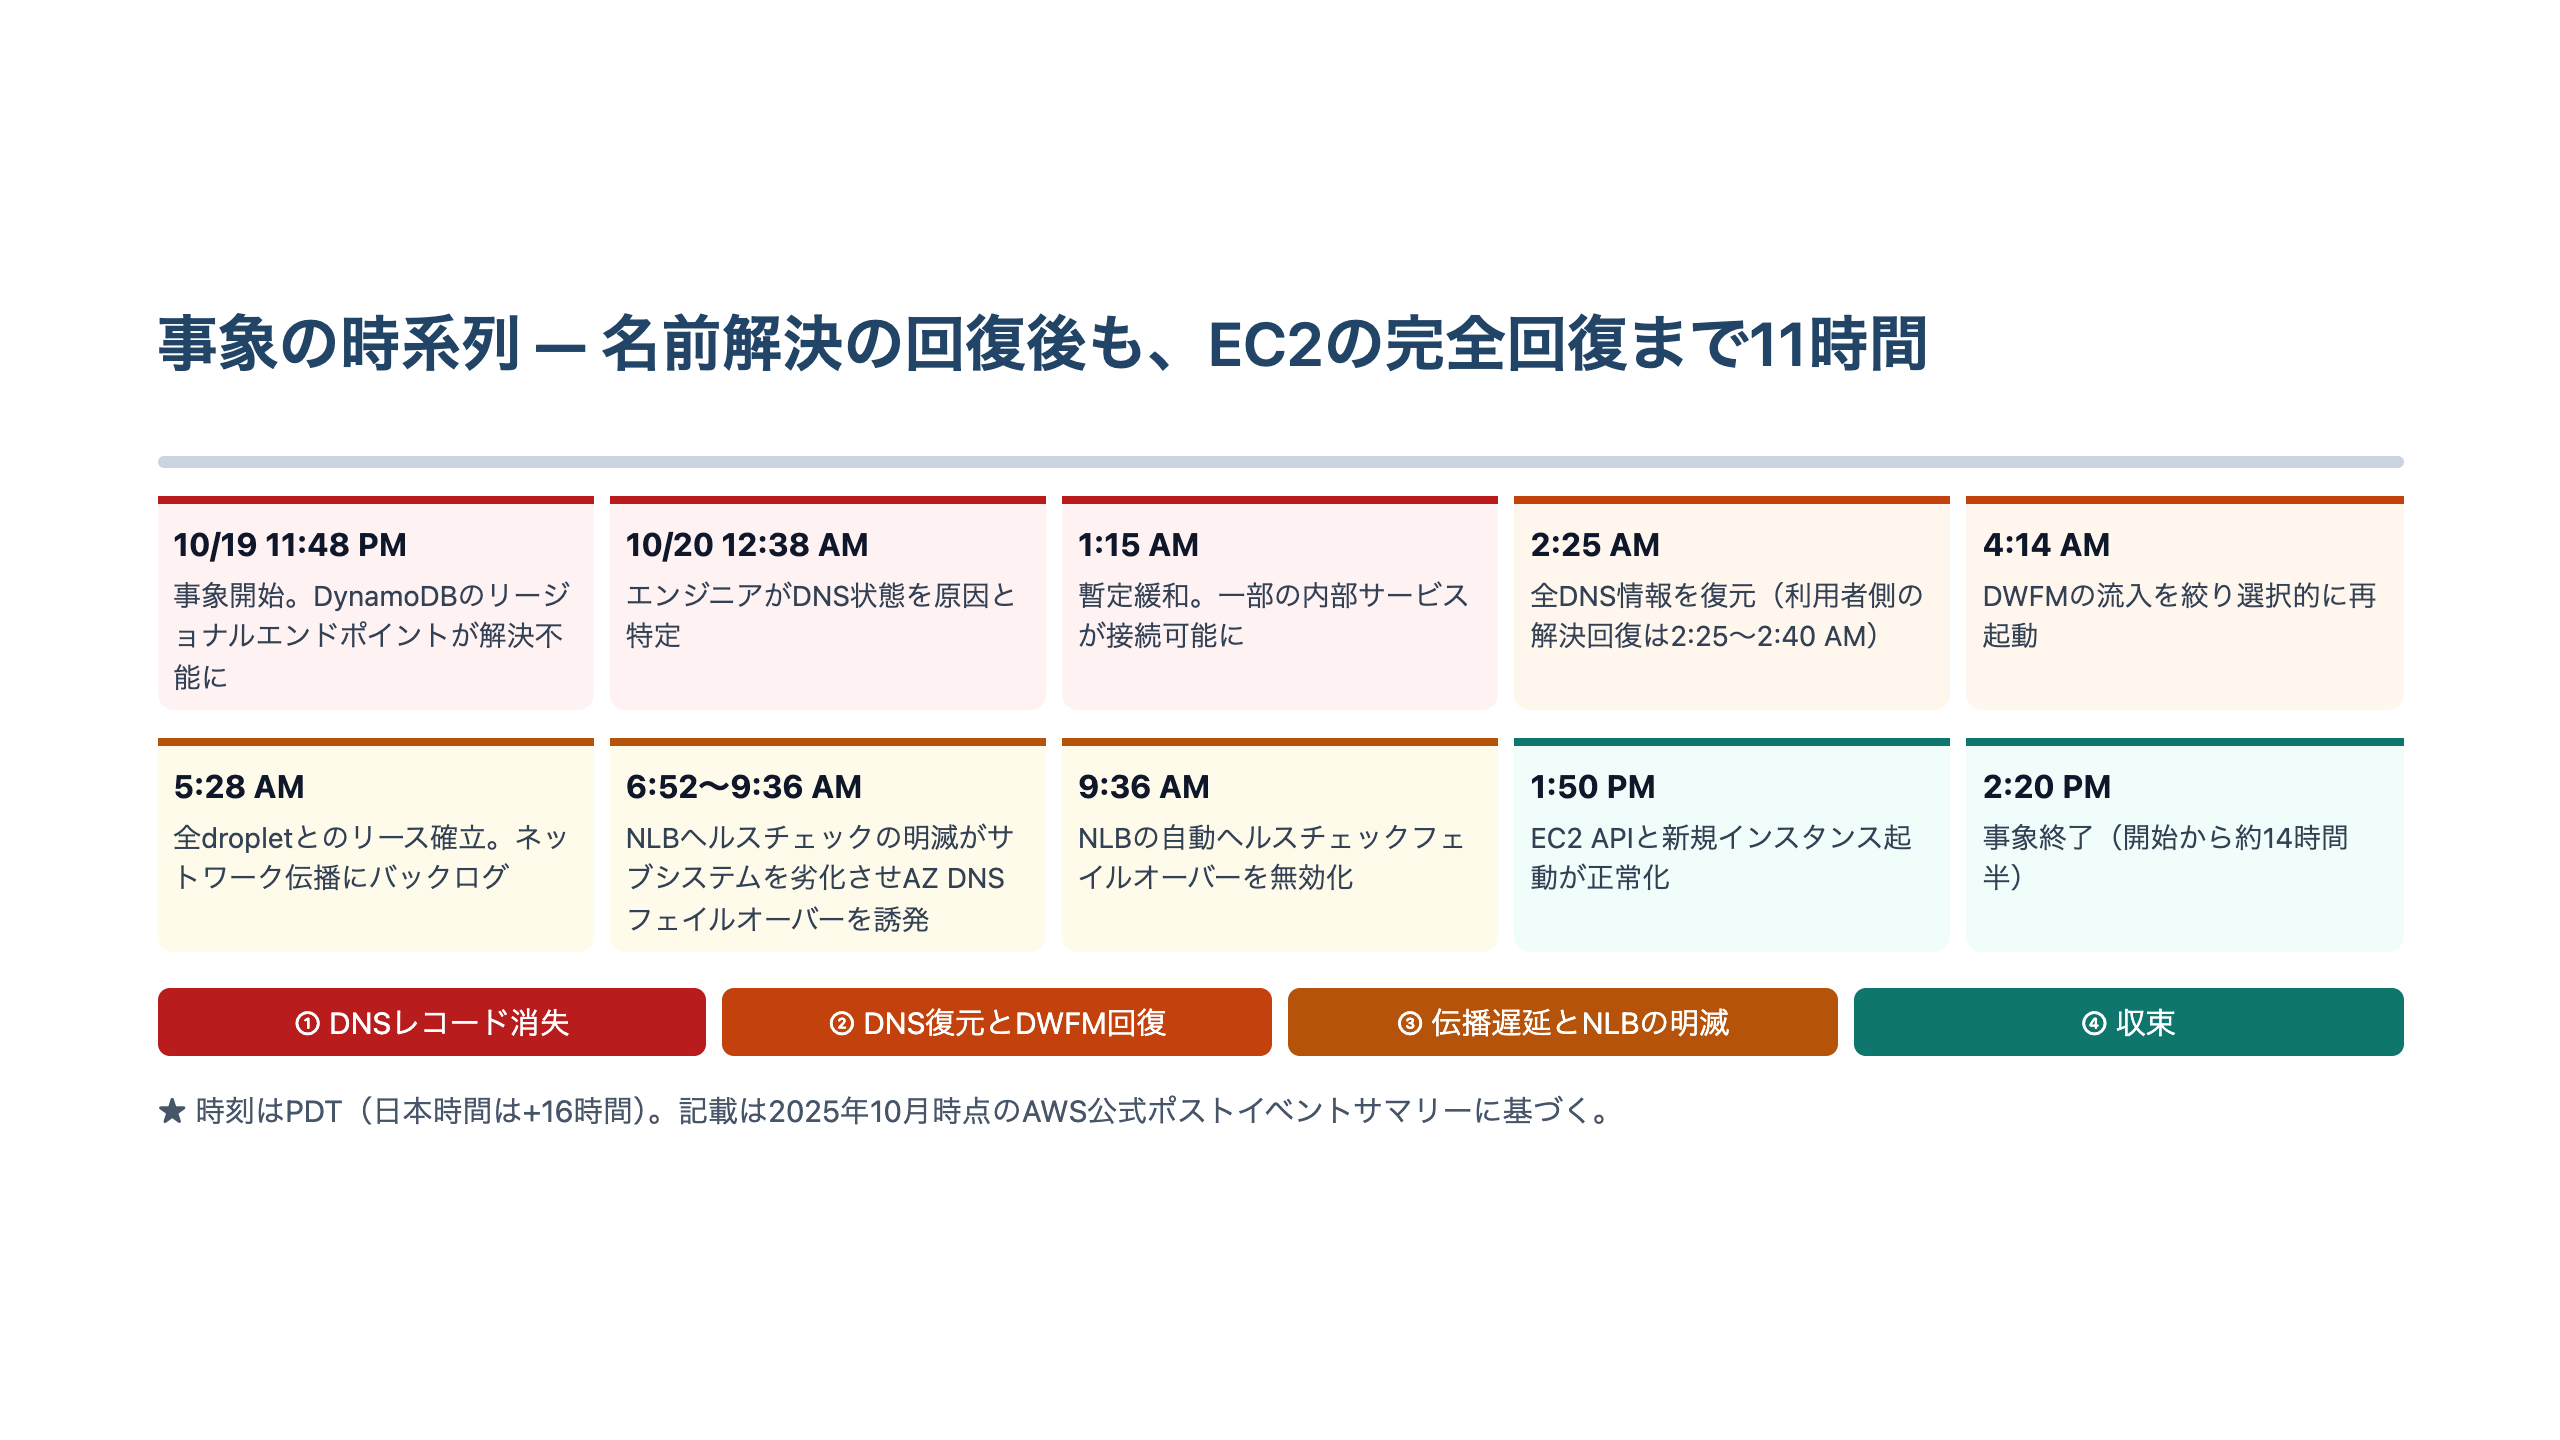
起点は、リージョナルエンドポイント dynamodb.us-east-1.amazonaws.com の名前解決ができなくなったことです。10月20日 12:38 AMにエンジニアがDNS状態を原因と特定、2:25 AMに全DNS情報が復元され、利用者側で解決できるようになったのは2:25 AMから2:40 AMの間でした。その後もEC2の新規インスタンス起動は5:28 AMまで「request limit exceeded」または「insufficient capacity」で失敗し、正常化は1:50 PMです。名前解決の回復まで約2時間50分、事象全体では約14時間半に及びました。
② 公式が説明する原因 — 2つのDNS Enactorがぶつかった
DynamoDBのDNS管理は、独立した2つの構成要素で成り立つと説明されています。DNS Planner はロードバランサーの健全性と容量を監視し、定期的に新しいDNSプラン(どのIPアドレスをエンドポイントに割り当てるかの計画)を作ります。DNS Enactor は依存関係を最小限にする設計とされ、3つのアベイラビリティゾーン(AZ)で冗長かつ完全に独立して動作し、新しいプランを探してRoute 53のトランザクションで現在のプランを置き換えます。適用の開始時には「直前に適用されたプランより新しいこと」を確認するチェックが入ります。
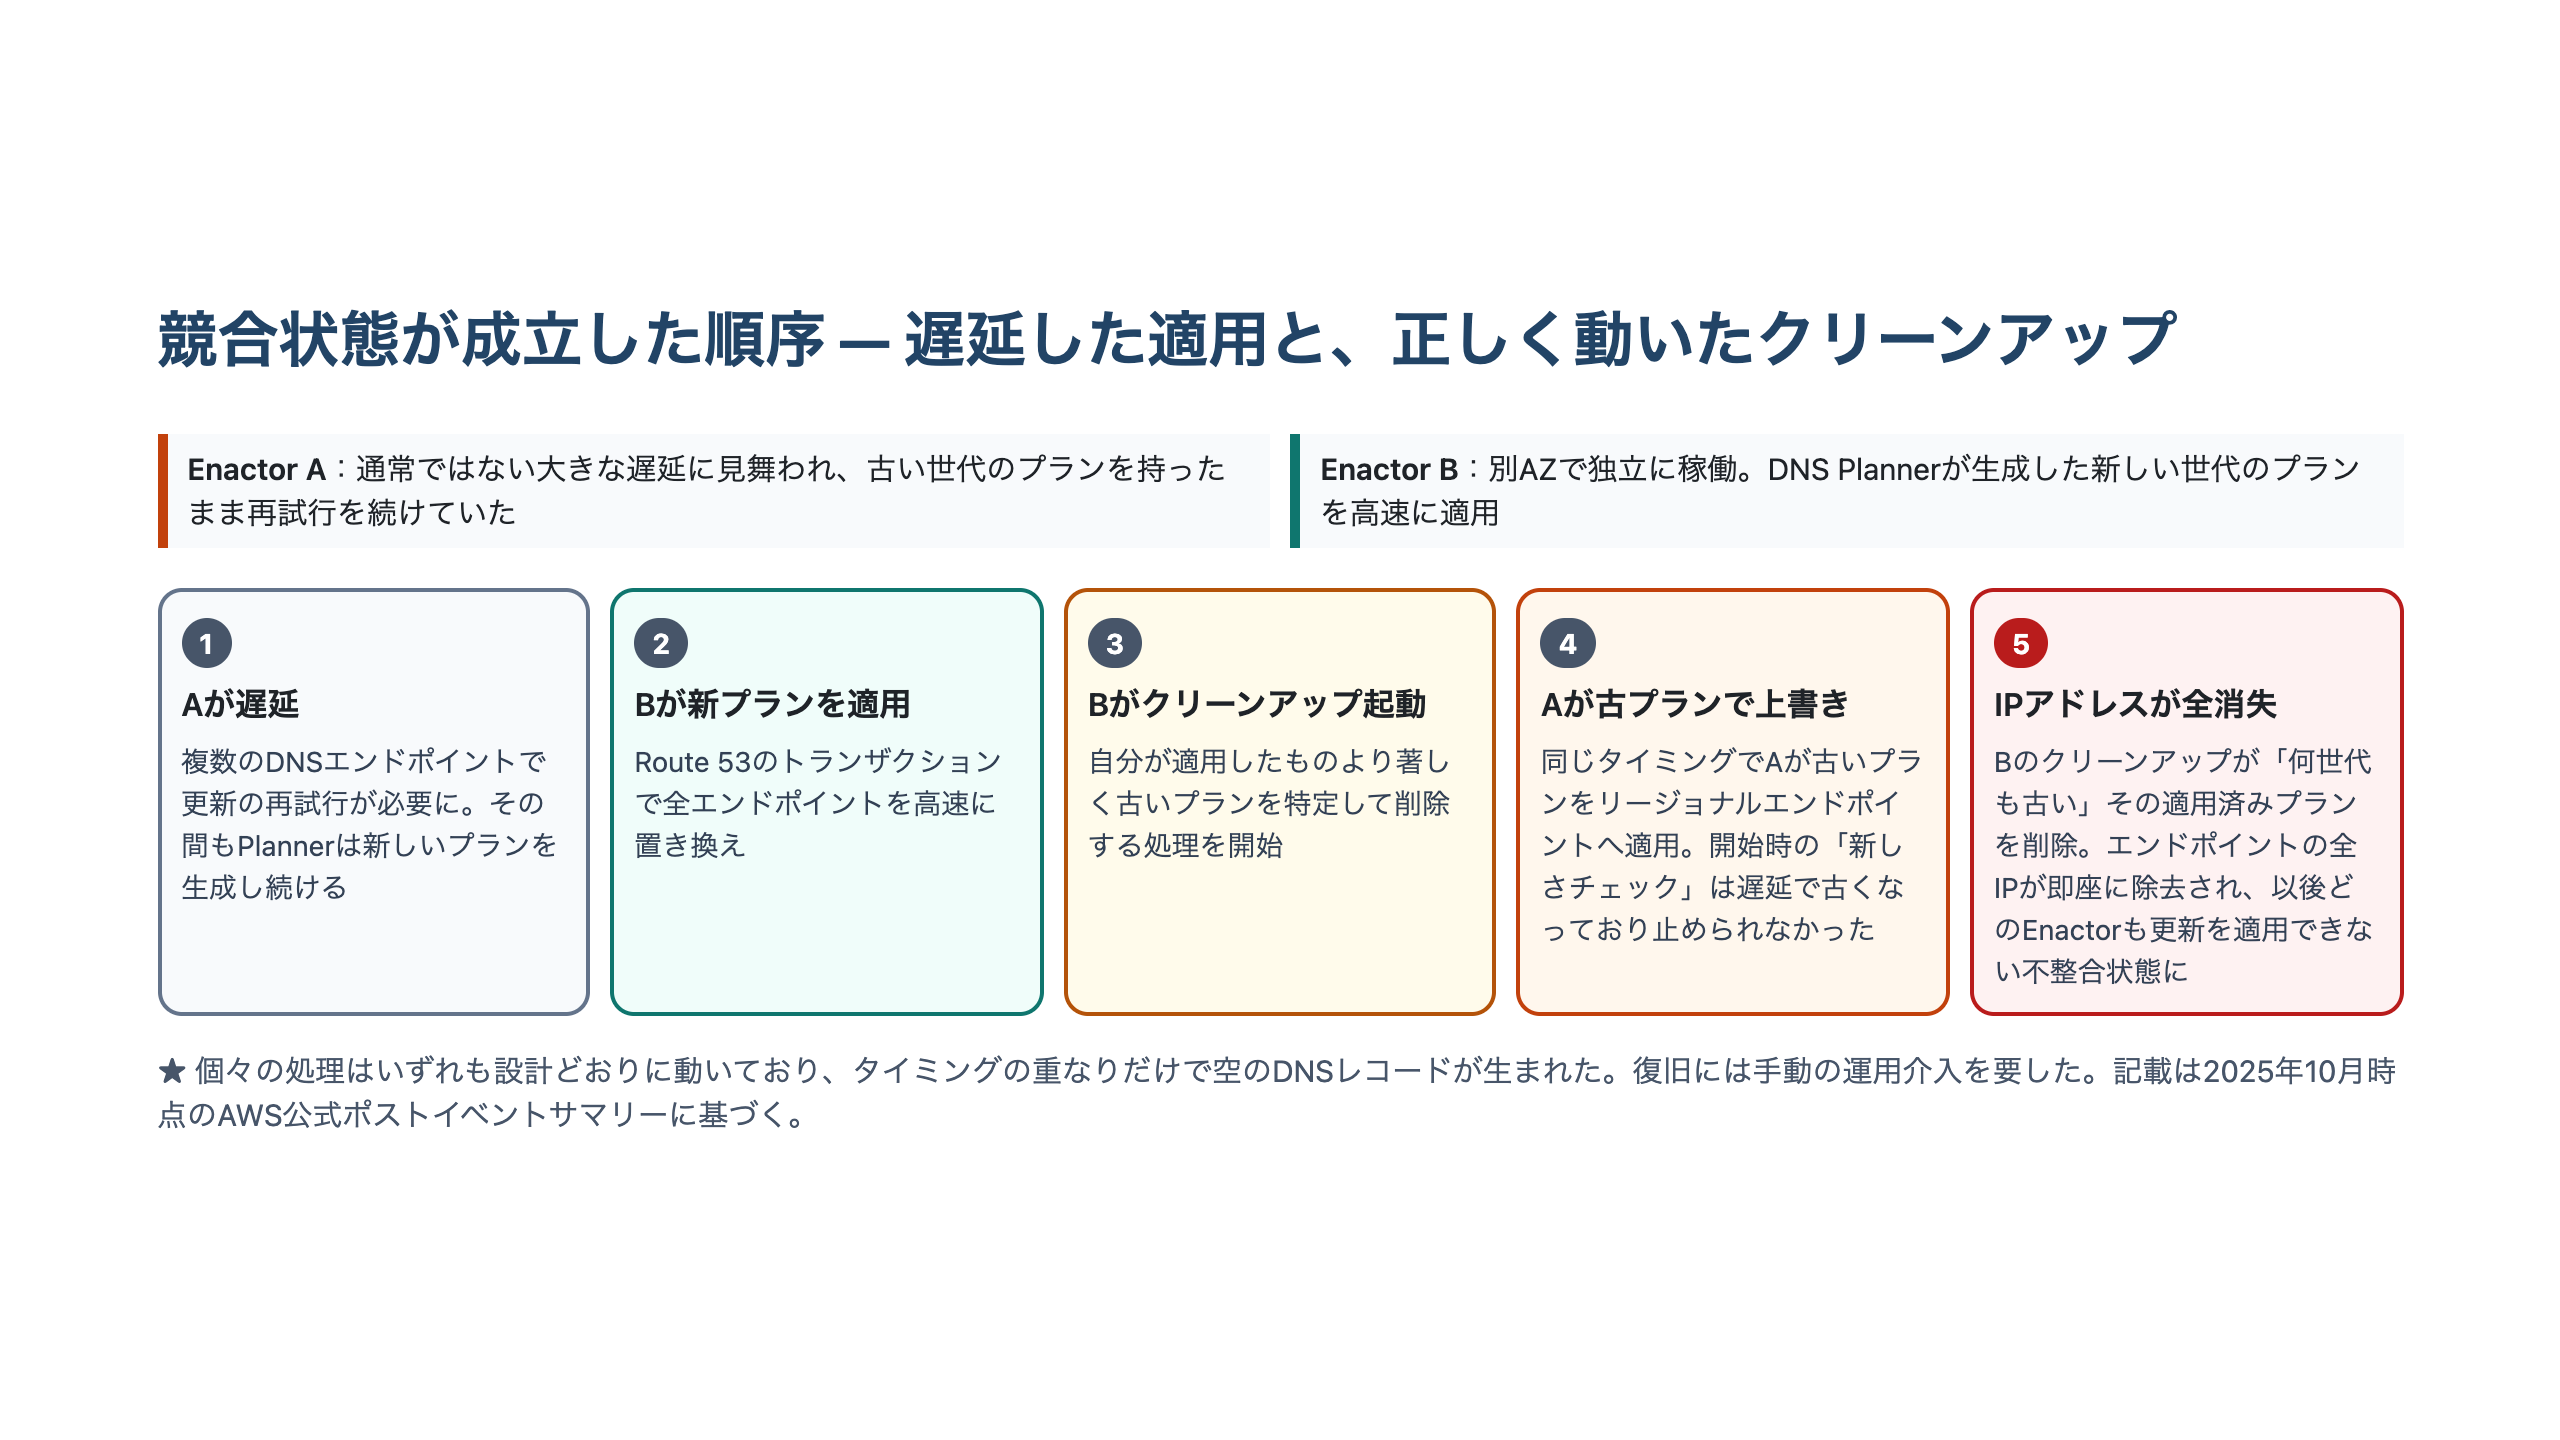
競合状態は次の順で成立したと記載されています。あるDNS Enactorが通常ではない大きな遅延に見舞われ、複数のDNSエンドポイントで更新の再試行を必要としました。その間もPlannerは新しい世代のプランを生成し続け、別のEnactorがそのひとつを適用して全エンドポイントを高速に処理します。この2番目のEnactorは続けて、自分が適用したものより著しく古いプランを削除するクリーンアップを起動しました。
ちょうど同じタイミングで、遅延していた1番目のEnactorが自分の持つ古いプランをリージョナルエンドポイントへ適用し、新しいプランを上書きします。適用開始時の「新しいことの確認」は異常な遅延によって古くなっており、上書きを止められませんでした。そしてクリーンアップが、適用されたばかりのこの古いプランを「何世代も古い」として削除し、すべてのIPアドレスが即座に取り除かれます。以後はどのEnactorも更新を適用できない不整合な状態となり、手動の運用介入を要しました。DynamoDB自体が停止したのではなく、エンドポイントを指すレコードが消えた事象です。
③ 影響はどこまで広がったか
公式サマリーが影響を記載しているサービスと時間帯です。
| サービス | 公式記載の影響 | 影響時間帯(PDT) |
|---|---|---|
| Amazon DynamoDB | 名前解決の失敗によるAPIエラー・接続失敗 | 11:48 PM〜2:40 AM |
| Amazon EC2 | 新規インスタンス起動の失敗、ネットワーク伝播の遅延 | 11:48 PM〜1:50 PM |
| Network Load Balancer | ヘルスチェックの明滅に伴う接続エラー | 10/20 5:30 AM〜2:09 PM |
| AWS Lambda | 関数の作成・更新の失敗、呼び出しのエラーと遅延 | 11:51 PM〜2:15 PM |
| ECS / EKS / Fargate | コンテナ起動の失敗、スケーリング遅延 | 11:45 PM〜2:20 PM |
| AWS STS | APIのエラーと遅延 | 11:51 PM〜9:59 AM |
| IAM | IAMユーザーでのコンソールサインイン失敗 | 11:51 PM〜1:25 AM |
| Amazon Connect | 通話・チャット・ケース等の処理でエラー増 | 11:56 PM〜1:20 PM |
| Amazon Redshift | クラスタ作成・変更のAPIエラー、IAM認証情報の利用不可 | 11:47 PM〜2:21 AM |
| AWSサポートコンソール | ケースの作成・閲覧・更新ができない | 11:48 PM〜2:40 AM |
(日付の記載がない行は、開始が10月19日・終了が10月20日)
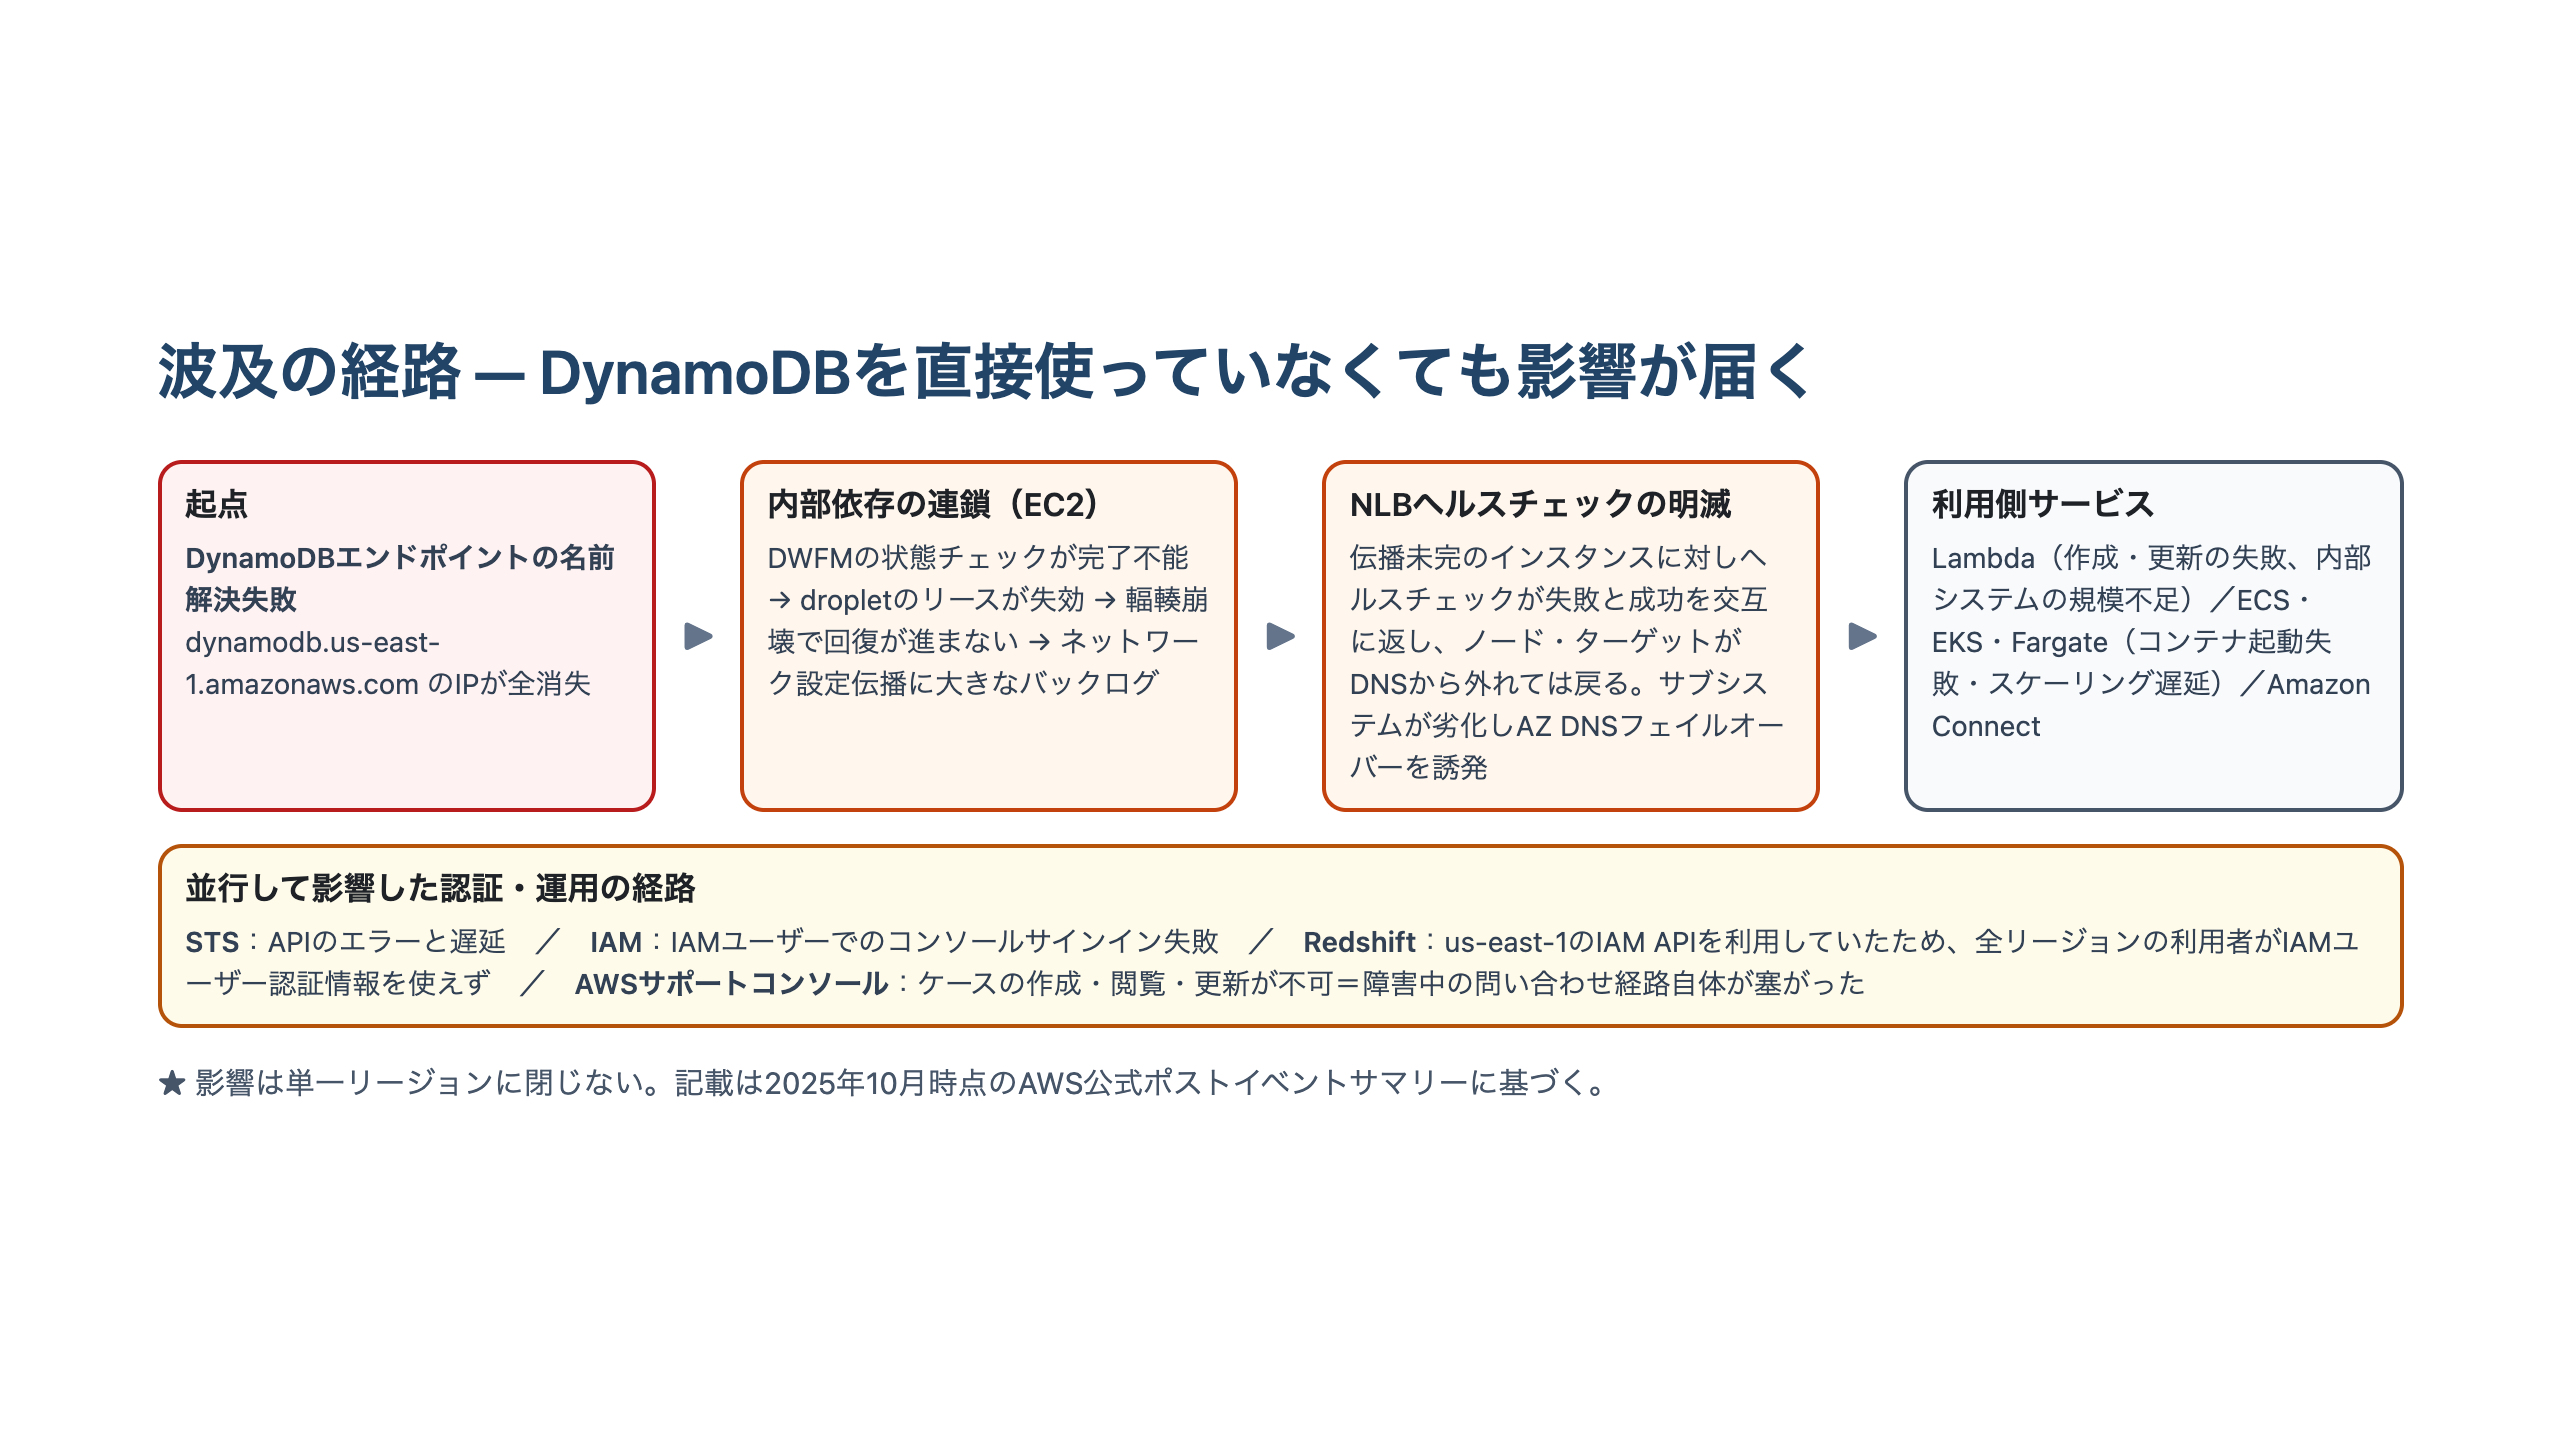
連鎖は二段です。第一段はDynamoDBに依存する内部コンポーネントで、EC2の物理サーバー群を管理するDropletWorkflow Manager(DWFM)は状態チェックが完了できず、リースが順次タイムアウトしました。2:25 AMのDynamoDB回復後もDWFMは輻輳崩壊(回復作業がタイムアウト前に終わらず再試行が積み上がる状態)に陥り、全リースの確立は5:28 AMです。
第二段は、その回復処理自体が生んだ波及です。伝播が追いつかないインスタンスにNLBのヘルスチェックが走り、失敗と成功が交互に出る明滅がサブシステムを劣化させて自動のAZ DNSフェイルオーバーを誘発しました(9:36 AMに無効化)。Lambdaもここを経由し、7:04 AM以降の規模不足による絞り込みが11:27 AMまで続いています。
④ 設計論点その1 — 独立に動くアクターの排他制御
ここからは記載から読み取れる設計上の論点です。公式サマリーが「こう設計せよ」と述べているわけではありません。3つのAZで完全に独立させたEnactorの設計は、Enactor自身の障害には強い一方、同じレコードへの書き込みが重なる余地を残します。
第一に、古さの判定をいつ行うか。新しさのチェックは適用の開始時に行われ、遅延しているあいだに古くなりました。確認から書き込みまでに時間が空く経路は自システムでも同じ構造で、条件の評価を書き込み操作そのものに含められるかが分かれ目です。
第二に、削除処理が他のアクターの適用と競合しうるか。単体では無害なクリーンアップが、直前に適用されたレコードを消しました。古さの判定基準が他アクターの直近の動作を知らない限り、正しく動いて見えたまま最新を壊し得ます。
第三に、自動化が作った不整合から自動化自身が抜け出せるか。今回はどのEnactorも更新を適用できず、手動介入を要しています。
AWSの是正策も同じ方向です。DNS PlannerとEnactorの自動化を全世界で既に無効化し、再有効化に先立って競合状態を修正し誤ったプランの適用を防ぐ保護を加えるとしています。あわせて、NLBのAZフェイルオーバー時に単一のNLBが除去できる容量を制限するvelocity control、DWFMの回復ワークフローを対象とするテストスイート、待機キューに応じたスロットリング改善が示されています。
⑤ 設計論点その2 — 単一エンドポイントへの依存が届く範囲
もうひとつの論点は、ひとつのリージョナルエンドポイントが解決できなくなったときに依存がどこまで届くかです。前節の表のうちEC2の新規起動はDWFMを経由した間接的な依存にあたり、DynamoDBを直接使っていなくても影響を受け得ました。
読みどころは2つです。ひとつは、Redshiftがus-east-1のIAM APIを利用していたため、全リージョンの利用者がIAMユーザー認証情報を使えなかったこと。グローバルな認証系がひとつのリージョンに置かれていれば、そこの障害は他リージョンにも届きます。もうひとつは、サポートケースの操作ができず、障害中の問い合わせ経路そのものが塞がったこと。運用手順が影響下のコンソールやサポートに依存していれば、復旧作業自体が止まります。
⑥ 明日できる点検
| 観点 | 点検する問い |
|---|---|
| 条件判定のタイミング | 確認から書き込みまで時間が空く経路で、書き込み時点に条件を再評価しているか |
| 削除・クリーンアップ | 「古いものを消す」処理が、他アクターの直近の書き込みを壊し得ない基準か |
| 自動化からの脱出 | 自動化が不整合を作った場合の手動復旧手順が用意されているか |
| 依存経路の可視化 | 認証・起動処理・運用手順を通じた間接的な依存先を洗い出しているか |
| リージョンをまたぐ依存 | 特定リージョンの認証・管理系に依存している箇所がないか |
| 運用経路の独立 | 復旧手順が、影響を受け得るコンソール・サポートだけに依存していないか |
まとめ
論点は3つです。第一に、起点はサービス本体の停止ではなく、DNS自動化に潜在していた競合状態が生んだ空のDNSレコードだったこと。第二に、独立して冗長化されたアクターが同じレコードを更新する構成で、適用開始時の新しさチェックが遅延によって古くなったこと。第三に、影響がEC2の新規起動から認証系・運用経路まで広がったことです。
本記事は2025年10月時点の事象と発表を扱っています。適用前に公式の最新情報を確認してください。