
ベクターDBを増やさない選択 — DynamoDBネイティブのベクター検索がRAG基盤の構成をどう変えるか
AWSは2026年8月5日、DynamoDBがベクター埋め込みをテーブル内にネイティブで保存・検索できる機能を発表しました。公式ドキュメントの記載に基づき、RAG基盤で専用ベクターDBを追加する構成とDynamoDB一系統に統合する構成の設計判断を整理します。
- #Amazon DynamoDB
- #ベクター検索
- #RAG
- #Amazon Bedrock
- #AWS
AWSは2026年8月5日、Amazon DynamoDBがベクター埋め込みをテーブル内にネイティブで保存・検索できる機能を発表しました。これまでRAG(Retrieval Augmented Generation)基盤を構築する際、DynamoDBに保存した運用データとは別に、専用のベクターデータベースを用意して埋め込みベクターを管理する構成が一般的でした。この記事は、公式発表とAWS公式ドキュメントの記載だけを材料に、何が変わったのか、そしてRAG基盤の構成をDynamoDB一系統に統合すべきか、専用ベクターサービスを維持すべきかという設計判断を整理します。対象読者は、Bedrock等を使ってRAG基盤を本番構築・運用しているエンジニアです。
そもそも「ベクター検索」と「RAG」とは
ベクター検索とは、テキストや画像などのデータを機械学習モデルで数値の配列(埋め込みベクター)に変換し、意味の近さをベクター同士の距離や角度で計算して検索する手法です。キーワードの完全一致ではなく「意味が近いもの」を見つけられるため、自然言語での検索やレコメンデーションに使われます。
RAGは、この仕組みを大規模言語モデル(LLM)と組み合わせるアーキテクチャです。ユーザーの質問文を埋め込みベクターに変換し、それに近い文書の埋め込みをベクター検索で取得したうえで、その文書をLLMのプロンプトに含めて回答を生成させます。社内文書やFAQなど、LLMが学習していない情報をもとに回答させたい場合の標準的な構成です。この基本を理解していれば、次節以降は読み飛ばして構いません。
なぜ「専用ベクターDBを増やす」ことが運用負債になっていたか
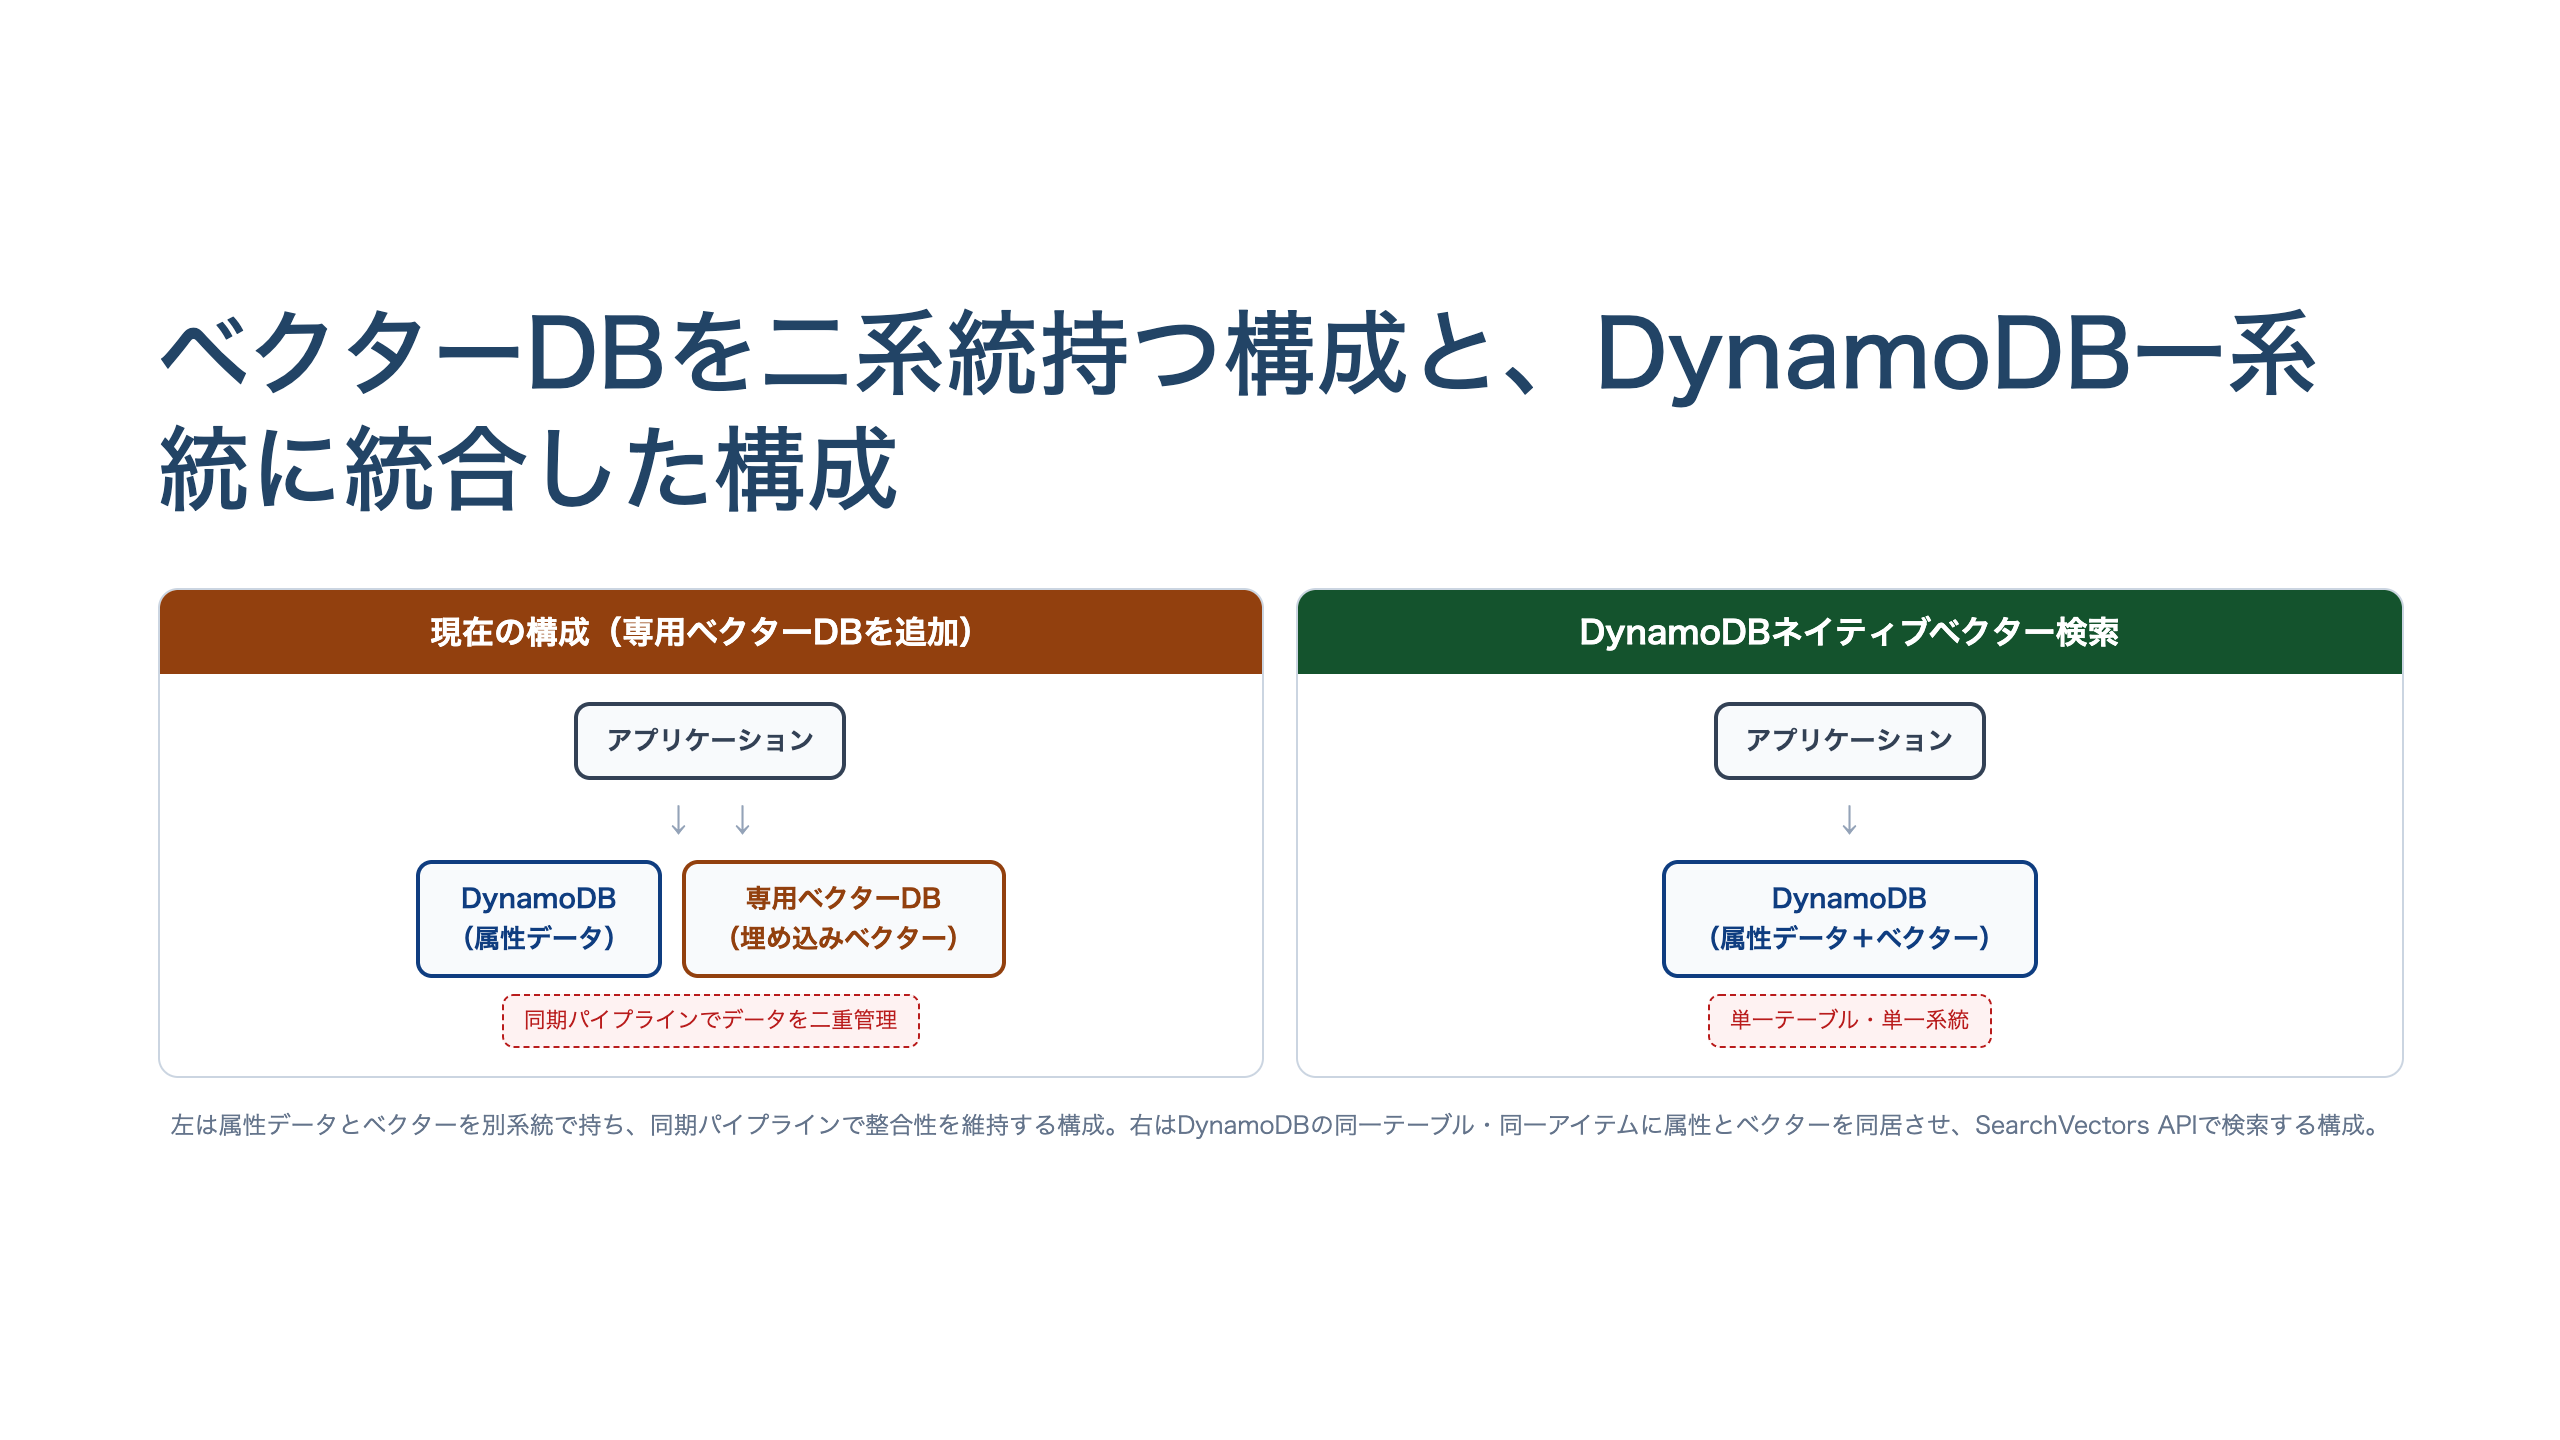
RAG基盤を構築する際、これまでの一般的な構成は、DynamoDB等の運用データベースとは別に、Amazon OpenSearch Serverlessのベクターエンジンのような専用のベクターデータベースを用意し、両者の間でデータを同期させるというものでした。
この構成には、いくつかの運用コストが伴います。ひとつは、同じ情報を2つのシステムに二重で持つことによるデータ整合性の管理です。運用データベース側でレコードが更新・削除されたとき、対応するベクターデータベース側の埋め込みも同期して更新しなければ、検索結果と実データがずれてしまいます。もうひとつは、2つのシステムそれぞれの容量計画・スケーリング・監視を個別に行う必要がある点です。システムの数が増えるほど、障害点も運用の手間も増えます。
DynamoDBのベクター検索は、この「同期の必要な二系統構成」を「単一テーブルの一系統構成」に置き換える選択肢として発表されました。
DynamoDBネイティブベクター検索で何が変わったか
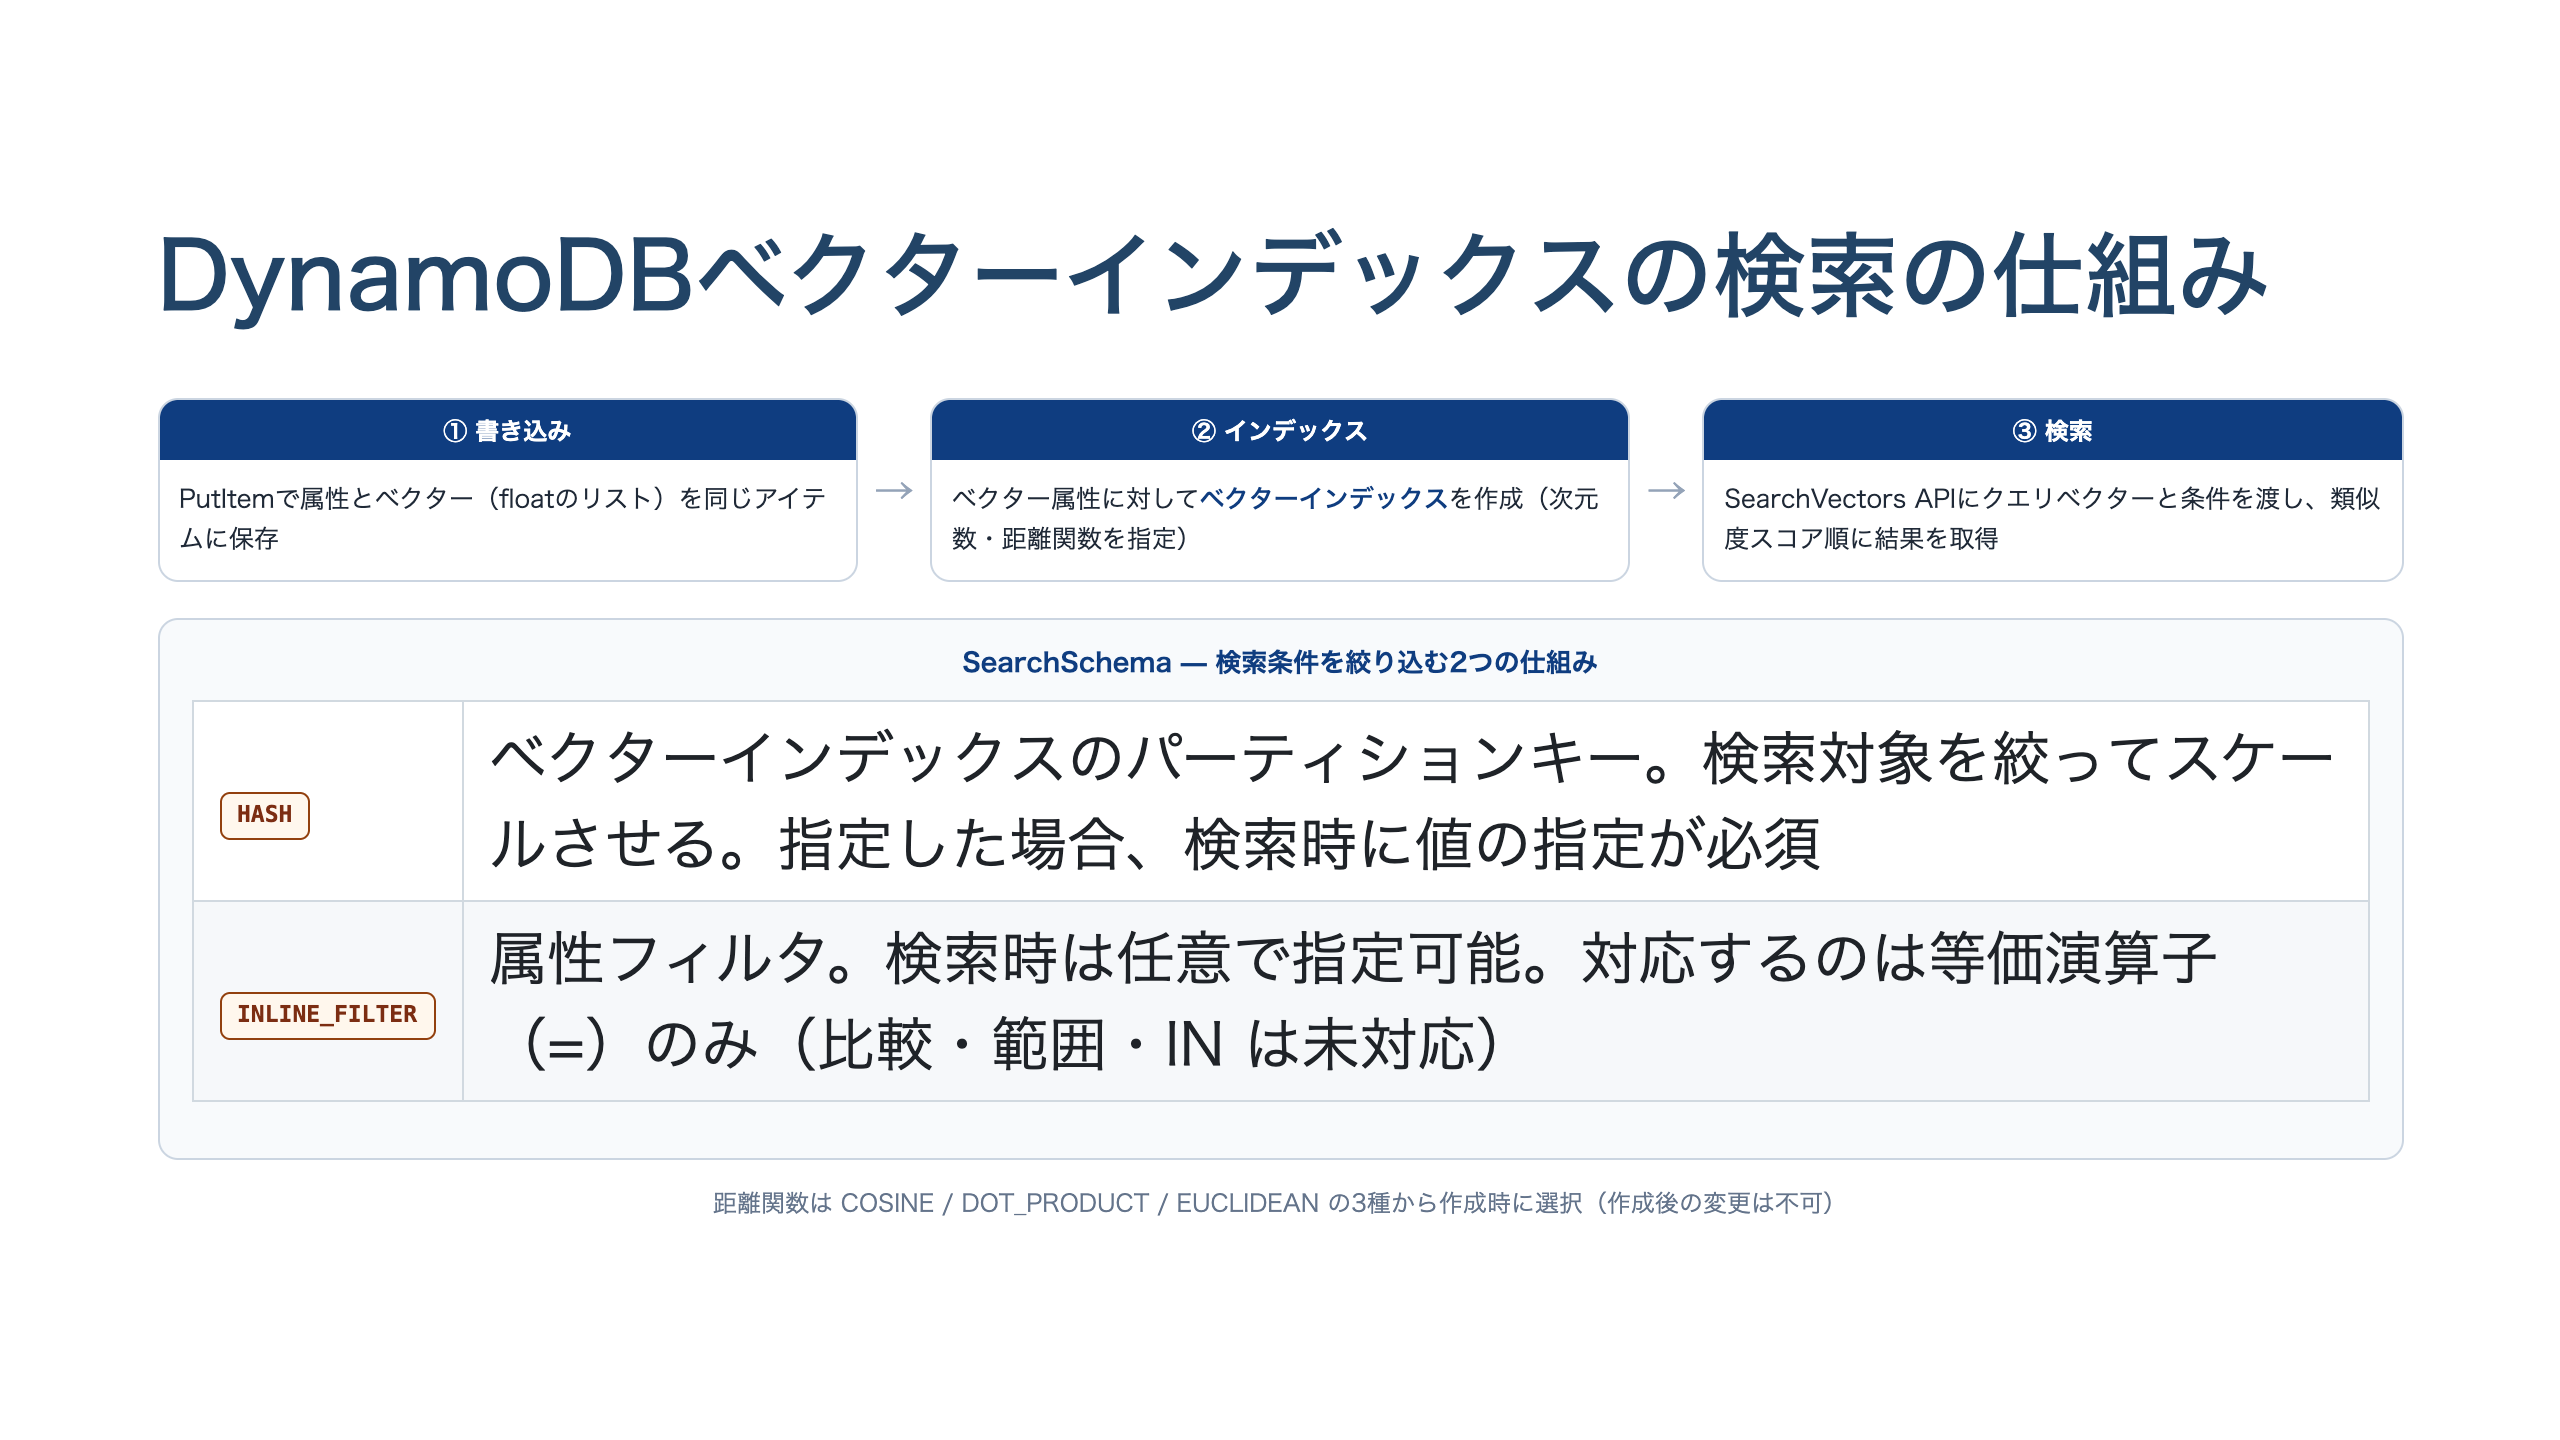
AWS公式の発表とDynamoDB開発者ガイドの記載によると、DynamoDBには新しいインデックス種別として「ベクターインデックス」が追加されました。ベクターインデックスは、グローバルセカンダリインデックスやローカルセカンダリインデックスと違い、完全一致・範囲検索ではなく、近似最近傍探索(ANN)による類似度検索を行う専用のインデックスです。検索は専用のSearchVectors APIを呼び出して実行し、類似度スコア順にランク付けされた結果が返ります。
仕組みはシンプルです。アプリケーションは、通常のPutItem呼び出しで、テーブルの他の属性と同じアイテムに、埋め込みベクター(floatのリスト)を1つの属性として保存します。そのうえで、ベクターを保存した属性に対してベクターインデックスを作成する際、次元数と距離関数(類似度の測り方)を指定します。DynamoDB開発者ガイドによると、距離関数は「COSINE」「DOT_PRODUCT」「EUCLIDEAN」の3種類から選べ、インデックス作成後に変更することはできません。テキスト埋め込みモデルでの意味的な類似検索であれば、方向のみを比較し大きさを無視するCOSINEが標準的な選択とされています。ベクターの生成には、Amazon Bedrockで提供されるモデルを含む任意の埋め込みモデルを利用できます。
検索条件の絞り込みには、SearchSchemaという設定で2種類の仕組みが用意されています。1つはHASH(ベクターインデックスのパーティションキー)で、カテゴリや国のような低〜中カーディナリティの属性を指定すると、検索対象を絞り込んでスケールさせられます。指定した場合、検索時にその値を渡すことが必須です。もう1つはINLINE_FILTER(インラインフィルタ)で、属性値でメタデータ絞り込みをしながら検索できる仕組みです。ただし現時点で対応するのは等価演算子(=)のみで、比較・範囲・INのような集合演算子には対応していません。
性能面では、AWS公式発表に「99%以上のリコール率で単一桁ミリ秒のレイテンシ」と明記されており、想定スケールは数十億から数兆単位のベクターとされています。運用面は完全サーバーレスで、インフラ管理・容量計画・メンテナンス時間が不要とAWSは説明しています。ベクターインデックスはオンデマンド容量モードのテーブルでのみ利用できる点は、既存テーブルへ導入する際の前提条件になります。
設計判断①: 既存DynamoDBテーブルへの統合が向くケース
すでにDynamoDBで運用データを管理しているシステムに、属性フィルタ付きのRAG検索を追加する場合、DynamoDBネイティブベクター検索への統合は運用負荷を明確に下げます。理由は2つです。1つは、同期パイプラインを新たに構築・保守する必要がなくなること。もう1つは、INLINE_FILTERによって、既存のテーブル属性(カテゴリ・所有者・作成日など)で絞り込みながら類似度検索できるため、「まず属性で絞ってからベクター検索する」という設計をアプリケーション側で組み立てる必要がなくなることです。特に、既存システムがすでにDynamoDBの容量モード・アクセスパターン設計に習熟している場合、新しいデータストアの学習コストを避けられる点は実務上のメリットになります。
設計判断②: それでも専用ベクターサービスを選ぶべきケース
一方で、公式ドキュメントの記載から確認できる機能差に基づけば、専用ベクターサービスが向くケースも残っています。DynamoDBのインラインフィルタが等価演算子のみに対応するのに対し、AWS公式のOpenSearch Serverlessベクターエンジンの説明ページによると、OpenSearchのベクターエンジンはHNSW(Hierarchical Navigable Small World)やIVF(Inverted File)といった複数の近似最近傍探索アルゴリズムに対応し、近似検索に加えて正確なk-NN検索も選択できます。比較・範囲条件を含む複雑なフィルタ条件や、検索アルゴリズム自体をワークロードに合わせてチューニングしたい場合は、DynamoDBの現状の機能では対応しきれません。
なお、AWS公式発表の本文には他のベクターデータベースサービスとの直接比較の記述はありません。この記事で挙げた機能差は、DynamoDB開発者ガイドとOpenSearch Serverlessの公式ページをそれぞれ確認したうえでの事実の突き合わせであり、優劣を断定するものではない点に注意してください。料金についても、DynamoDB側の公式発表に具体的な言及はなく、この記事では料金の優劣を判断していません。
実務で使うときの注意点
既存テーブルにベクターインデックスを追加する場合、いくつか確認すべき制約があります。DynamoDB開発者ガイドによると、1テーブルに作成できるベクターインデックスは最大5個までです。また、DynamoDB Accelerator(DAX)はSearchVectors操作に対応していないため、DAXを経由したキャッシュ読み取りを行っているシステムでは、ベクター検索のリクエストだけはDynamoDBへ直接送る設計にする必要があります。グローバルテーブル構成では、ベクターインデックスの定義はレプリカリージョンへ自動的に複製されますが、書き込んだベクターが他リージョンの検索結果に反映されるまでの複製は非同期であり、リージョン間で一時的に検索結果が異なる可能性がある点も踏まえておく必要があります。ポイントインタイムリカバリやバックアップからの復元時は、ベクターインデックスはベーステーブルのデータから再構築(バックフィル)されるため、IndexStatusがACTIVEになるまで待ってから検索を行う必要があります。
まとめ
- DynamoDBは2026年8月5日、テーブル属性と同居する形でベクターをネイティブに保存・検索できる機能を発表しました。99%以上のリコール率・単一桁ミリ秒のレイテンシで、数十億から数兆単位のベクターに対応するとAWSは説明しています。
- 既存のDynamoDBテーブルにRAG検索を統合する場合、同期パイプラインが不要になり、属性フィルタ(等価条件)と組み合わせた検索ができる点が運用負荷を下げます。
- インラインフィルタは等価演算子のみの対応であり、複雑なフィルタ条件や検索アルゴリズムの選択が必要な場合は、専用ベクターサービスとの機能差を公式ドキュメントで確認したうえで選ぶ必要があります。
出典
- Amazon DynamoDB now supports real-time vector search at any scale(AWS公式 What’s New・2026年8月5日)
- Using vector indexes in DynamoDB(Amazon DynamoDB 開発者ガイド)
- Amazon OpenSearch Serverless vector engine(AWS公式サービスページ)