
DynamoDB に S3 からの一括投入(Bulk Put Items)が付いた — 既存テーブルへ流す前に決める条件式・Streams・結果検証
Amazon DynamoDBの既存テーブルへ、S3のファイルを非同期ジョブで書き込めるBulk Put Itemsが一般提供になりました。レコード単位の条件式、条件スキップの記録方法、Streams・DAX・グローバルテーブルとの関係、バイト単位課金の要点を整理します。
- Amazon DynamoDB
- Amazon S3
AI要約
- 既存のDynamoDBテーブルに、S3の入力ファイルから非同期ジョブで書き込める(2026年11月5日発表)
- 条件式はレコードごとに付けられ、条件に弾かれた項目は失敗に数えられない
- 条件スキップの記録はOutputTypeでCONDITION_CHECK_FAILUREを指定した場合のみ残る
- Streamsは書き込みごとにレコードが出て、DAXは素通りし、グローバルテーブルは対象外
2026年11月5日、AWSはAmazon DynamoDBのBulk Put Items(一括投入)を一般提供したと発表しました。S3に置いたデータを、すでに存在するDynamoDBテーブルへ非同期ジョブで書き込む機能です。従来のS3からのインポートは新規テーブルの作成専用で、既存テーブルへの投入は自前のスクリプトで行う必要がありました。この記事では、仕組みと、流し込む前に決めておく項目(条件式・出力レポート・Streams・DAX・課金)を整理します。
従来との違い — 既存テーブルに入れる手段が自前実装だった
DynamoDBのS3インポートは、S3のデータから新しいテーブルを作る機能です。すでに本番で動いているテーブルに、日次の更新データやバックフィル(過去データの補正投入)を流したい場合は、BatchWriteItemなどを呼ぶ自前のパイプラインを作り、テーブルの容量を管理する必要がありました。AWSの発表は、Bulk Put Itemsによって、既存のワークロードに影響を与えず、自前のパイプラインを作らずに書き込めるとしています。
仕組み
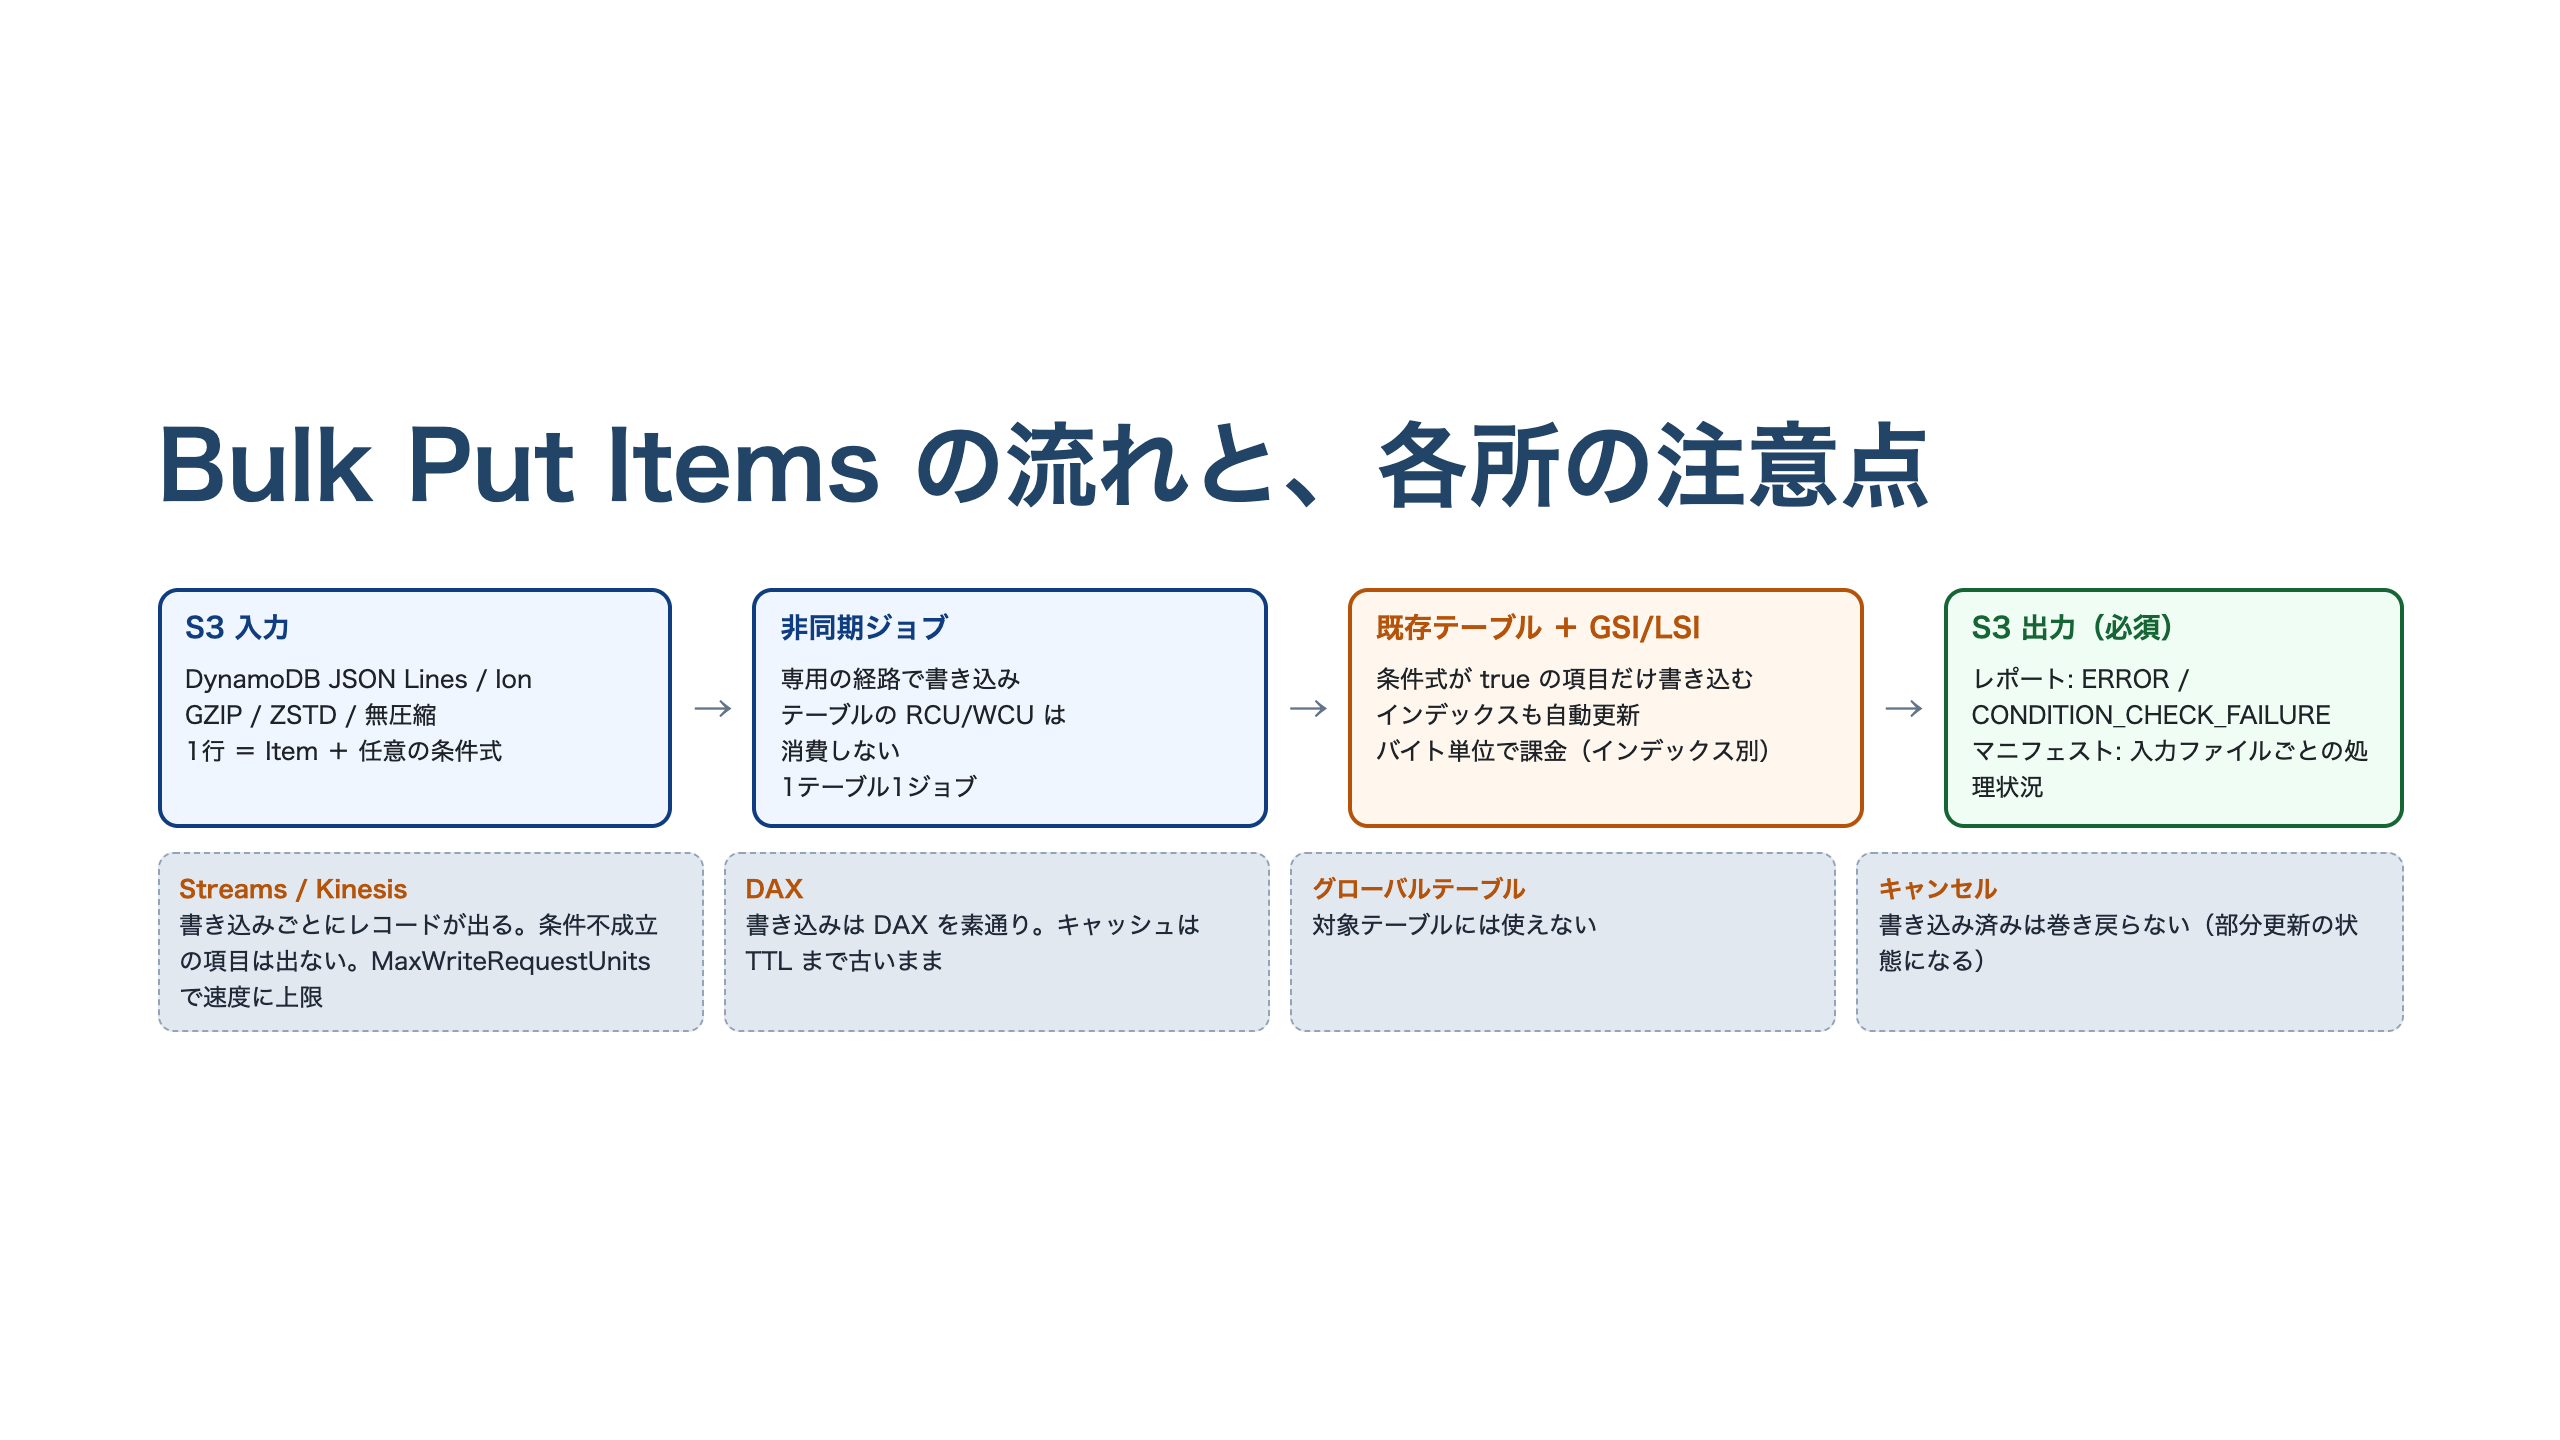
入力として、S3の入力ファイルの場所、書き込み先のテーブル、レポートの出力先S3、そして任意でパフォーマンスティアを渡します。DynamoDBがS3のオブジェクトを読み、各項目をテーブルへ書き込み、再試行や例外の扱いも担います。書き込みはテーブルとは別の経路で行われ、テーブルの読み取り・書き込みキャパシティを消費しません。操作にはStartBulkPutItems、DescribeBulkOperation、ListBulkOperations、CancelBulkOperationのAPIを使います。
入力はDynamoDB JSON(1行1レコードのJSON Lines)またはAmazon Ionで、GZIP・ZSTD・無圧縮に対応します。1レコードには、項目(Item)と、任意の条件式を載せます。
設計判断・実務での注意点
1. 条件式はレコードごとに付ける
条件式は、そのレコードを書き込んでよいかを判定します。trueなら書き込み、そうでなければスキップされます。構文や関数はPutItemと同じです。たとえばattribute_not_exists(pk)なら挿入のみ(既存項目は上書きしない)、バージョン属性を比較する式なら、新しい場合だけの上書きになります。条件を付けなかったレコードは、同じキーの既存項目を無条件に上書きします。 無条件、挿入のみ、バージョンガードを1つのファイルに混在させられますが、全レコードに同じ条件を適用したい場合は、全レコードに条件を付ける必要があります。
アプリケーションが同じキーに書き込みながらジョブが動く場合は特に注意が必要です。ドキュメントによれば、内部のフェイルオーバーの後に、一部のレコードが2回書き込まれることがあります。条件のないレコードの再書き込みは、アプリケーションの新しい書き込みを上書きし得ます。そのため、項目にバージョン属性を持たせ、attribute_not_exists(#v) OR #v < :newのような条件で守る例が示されています。
2. 結果の検証は、レポートとマニフェストで行う
条件に弾かれた項目は、失敗として数えられません。DescribeBulkOperationが返す2つの件数の意味にも注意が必要です。
| 項目 | 意味 |
|---|---|
ProcessedItemCount | 読み込んだ入力レコード数(検証エラーや条件不成立を含む)。書き込んだ件数ではない |
FailedItemCount | 検証エラーなど決定的な理由で失敗した件数。条件不成立は含まれない |
条件不成立の件数はDescribeBulkOperationに出ません。出力レポートに残すかどうかは、開始時のOutputTypeで決まります。 ERRORは検証エラーなど、CONDITION_CHECK_FAILUREは条件不成立の項目を記録します。条件スキップを検証したい場合は、後者も指定しておく必要があります(両方の指定も可能です)。
照合の手順は、ステータスが完了系になるまでDescribeBulkOperationを確認し、S3出力先のマニフェストと全レポートファイルを読む、というものです。マニフェストには入力オブジェクトごとにFULLY_PROCESSED、PARTIALLY_PROCESSED、NOT_PROCESSED、NOT_AVAILABLEのいずれかが記録されます。レポートを読む権限(s3:ListBucketとs3:GetObject)は書き込み用のポリシーに含まれないため、確認する側に別途付与します。
なお、出力先S3の指定は必須です。S3BucketOwnerが誤っていると、書き込みが進んだ後でS3AccessDeniedにより操作が失敗し、レポートもマニフェストも出力されない場合があるとドキュメントは記載しています。
3. Streams・DAX・グローバルテーブル
- Streams / Kinesis: ストリームを有効にしたテーブルでは、書き込みごとにストリームレコードが生成されます。条件チェックに失敗した項目は生成されません。通常の書き込みを想定したコンシューマーは遅れる可能性があり、DynamoDB Streamsの保持は24時間のため、それを超えて遅れるとレコードを失います。
MaxWriteRequestUnits(最小1,024)でジョブの書き込み速度に上限を設定できます。 - DAX: 一括書き込みはDAXを経由しないため、キャッシュ済みの項目はTTLが切れるまで古いままです。
- グローバルテーブル: 非対応です。対象テーブルでは開始できず、実行中のテーブルにレプリカも追加できません。
- メトリクス: キャパシティを消費しないため、
ConsumedWriteCapacityUnitsには現れません。進捗はDescribeBulkOperationとS3の出力で追います。
4. 同時実行と中断
1テーブルで同時に動かせるジョブは1つです。インデックスの作成中は開始できません。Quotasページには、1アカウント・1リージョンあたりの同時実行数(StandardとAcceleratedを別々に数え、それぞれ5)、1回の入力の合計サイズ(Standardは100 GB、Acceleratedは1 TB)、入力オブジェクト数(最大50,000)、1オブジェクトのサイズ(最大5 GB)が記載されています。キャンセルしても書き込み済みの項目は巻き戻らず、テーブルは部分的に更新された状態で残ります。
5. ティアと課金
ティアはSTANDARD(既定。コスト重視)とACCELERATED(スループット重視)です。Acceleratedはベクトルインデックス付きテーブルでは使えず、対応リージョンも限られます。ドキュメントの完了時間の目安は、1 KBの項目で1億件が1時間未満、10億件が2〜4時間(Accelerated)ですが、インデックスなし、キーが均等に分散、入力が複数オブジェクトに分割済み、という条件付きの見積りで、実際はテーブル規模・項目サイズ・キー分布・インデックス数に左右されます。
課金は書き込んだバイト数(GB)単位で、項目あたり最小1 KBです。テーブルと各インデックスに別々に計上され、1 KBの最小値もそれぞれに適用されます。Acceleratedは、Standardより高い料金で課金されます。単価はティアとテーブルクラスで決まり、金額は公式の料金ページ(Bulk put items)で確認してください。検証で弾かれた項目は課金されませんが、テーブルまで到達して条件チェックに失敗した項目は書き込みとして課金されます。 進捗と使用量はBulkOperationUsageで確認できます。
まとめ
- DynamoDBの既存テーブルに、S3のファイルを非同期ジョブで書き込めるようになりました。テーブルのキャパシティは消費しません。
- 条件式はレコード単位です。条件を付けなければ無条件の上書きになり、条件スキップは失敗に数えられず、
OutputTypeで指定しない限りレポートにも残りません。 - 流し込む前に、条件式、Streamsコンシューマーの余力、DAXのキャッシュ、結果の照合手順、キャンセル時の部分更新を決めておいてください。
出典
- Amazon DynamoDB now supports bulk put items(What’s New。一般提供の発表、既存テーブルへの書き込み、項目ごとの条件式、Standard・Acceleratedの2ティア、提供リージョンを記載。閲覧日: 2026年11月11日)
- Introducing bulk put items for Amazon DynamoDB: Load data from Amazon S3 into existing tables at scale(AWS Database Blog。条件式の使い方、ベストプラクティスを参照。閲覧日: 2026年11月11日)
- Working with bulk put items(開発者ガイド。仕組み、入力・出力、条件式の既定の挙動を参照。閲覧日: 2026年11月11日)
- Performance tiers(開発者ガイド。ティアの違い、完了時間の目安とその前提条件を参照。閲覧日: 2026年11月11日)
- Amazon S3 input formats for bulk put items(開発者ガイド。入力形式と圧縮形式、レコード単位の条件式を参照。閲覧日: 2026年11月11日)
- Bulk put items output and reconciliation(開発者ガイド。OutputType、ProcessedItemCountとFailedItemCountの意味、マニフェスト、課金の扱いを参照。閲覧日: 2026年11月11日)
- Bulk put items considerations, quotas, and permissions(開発者ガイド。グローバルテーブル、Streams、DAX、キャンセル、同時書き込みの注意を参照。閲覧日: 2026年11月11日)
- Amazon DynamoDB pricing(公式料金ページ。Bulk put itemsの課金の考え方(書き込みバイト数単位、項目あたり最小1 KB、インデックスごとの独立計上、Acceleratedが高料金、検証で弾かれた項目は非課金・条件チェック失敗は課金)を参照。閲覧日: 2026年11月11日)
- Quotas in Amazon DynamoDB(Bulk put itemsの節。同時実行数、入力サイズ、オブジェクト数・サイズ、MaxWriteRequestUnitsの最小値を参照。閲覧日: 2026年11月11日)
For Freelancers
データ基盤の案件を募集しています
この記事の技術に近い、いま募集中の業務委託案件です。