
ECS Managed Daemonsに「非クリティカル」ができた — 監視エージェントを落としても本番を止めない設計
Amazon ECS Managed Daemonsに、デーモンの重要度を指定できるcriticalパラメータが追加されました。既定のcritical(重要)扱いとの挙動の違い、non-critical(非クリティカル)にした場合に自分で用意すべき監視の設計判断を整理します。
- Amazon ECS
AI要約
- ECS Managed Daemonsのデーモンにcritical/non-criticalを指定できるようになった
- 既定(critical)はデーモン障害時にインスタンスごとdrain&replaceされる
- non-criticalにするとインスタンスは継続稼働するが、障害の自動シグナルが消える
- EventBridgeイベント・サービスアクションログを自前で監視する設計が必要になる
2026年9月3日、AWSはAmazon ECS Managed Daemonsのデーモンタスクに対して、重要度を指定できるcriticalパラメータを追加したと発表しました。これまでデーモンタスクが停止・不健全化すると、コンテナインスタンスごと自動的に退避(drain)・置き換えされる挙動に固定されていましたが、criticalをfalseに設定することで、この挙動を用途に応じて緩められるようになりました。この記事では、既定の挙動との違いと、設定変更時に見落としやすい監視設計の注意点を整理します。
前提 — Managed Daemonsの既定動作
Amazon ECS Managed Daemonsは、ECS Managed Instances上で、セキュリティ・可観測性・ネットワーキングなどのエージェントをデーモンタスクとして配布・管理する仕組みです。デーモンタスク定義を登録し、クラスターとキャパシティプロバイダーに紐づけると、そのキャパシティプロバイダー経由でプロビジョニングされるすべてのEC2インスタンスに対して、デーモンタスクがちょうど1つずつ稼働するようにECSが管理します。
デーモンには、いずれの重要度設定でも共通する起動順序があります。ECSはまずEC2インスタンスをプロビジョニングし、デーモンタスクを起動したうえで、はじめてアプリケーションタスクをRUNNING状態に遷移させます。この順序はcriticalityの設定に関わらず共通で、ログ収集・トレーシング・メトリクス収集のような横断的な機能を、アプリケーションの処理開始前に確実に稼働させるためのものです。
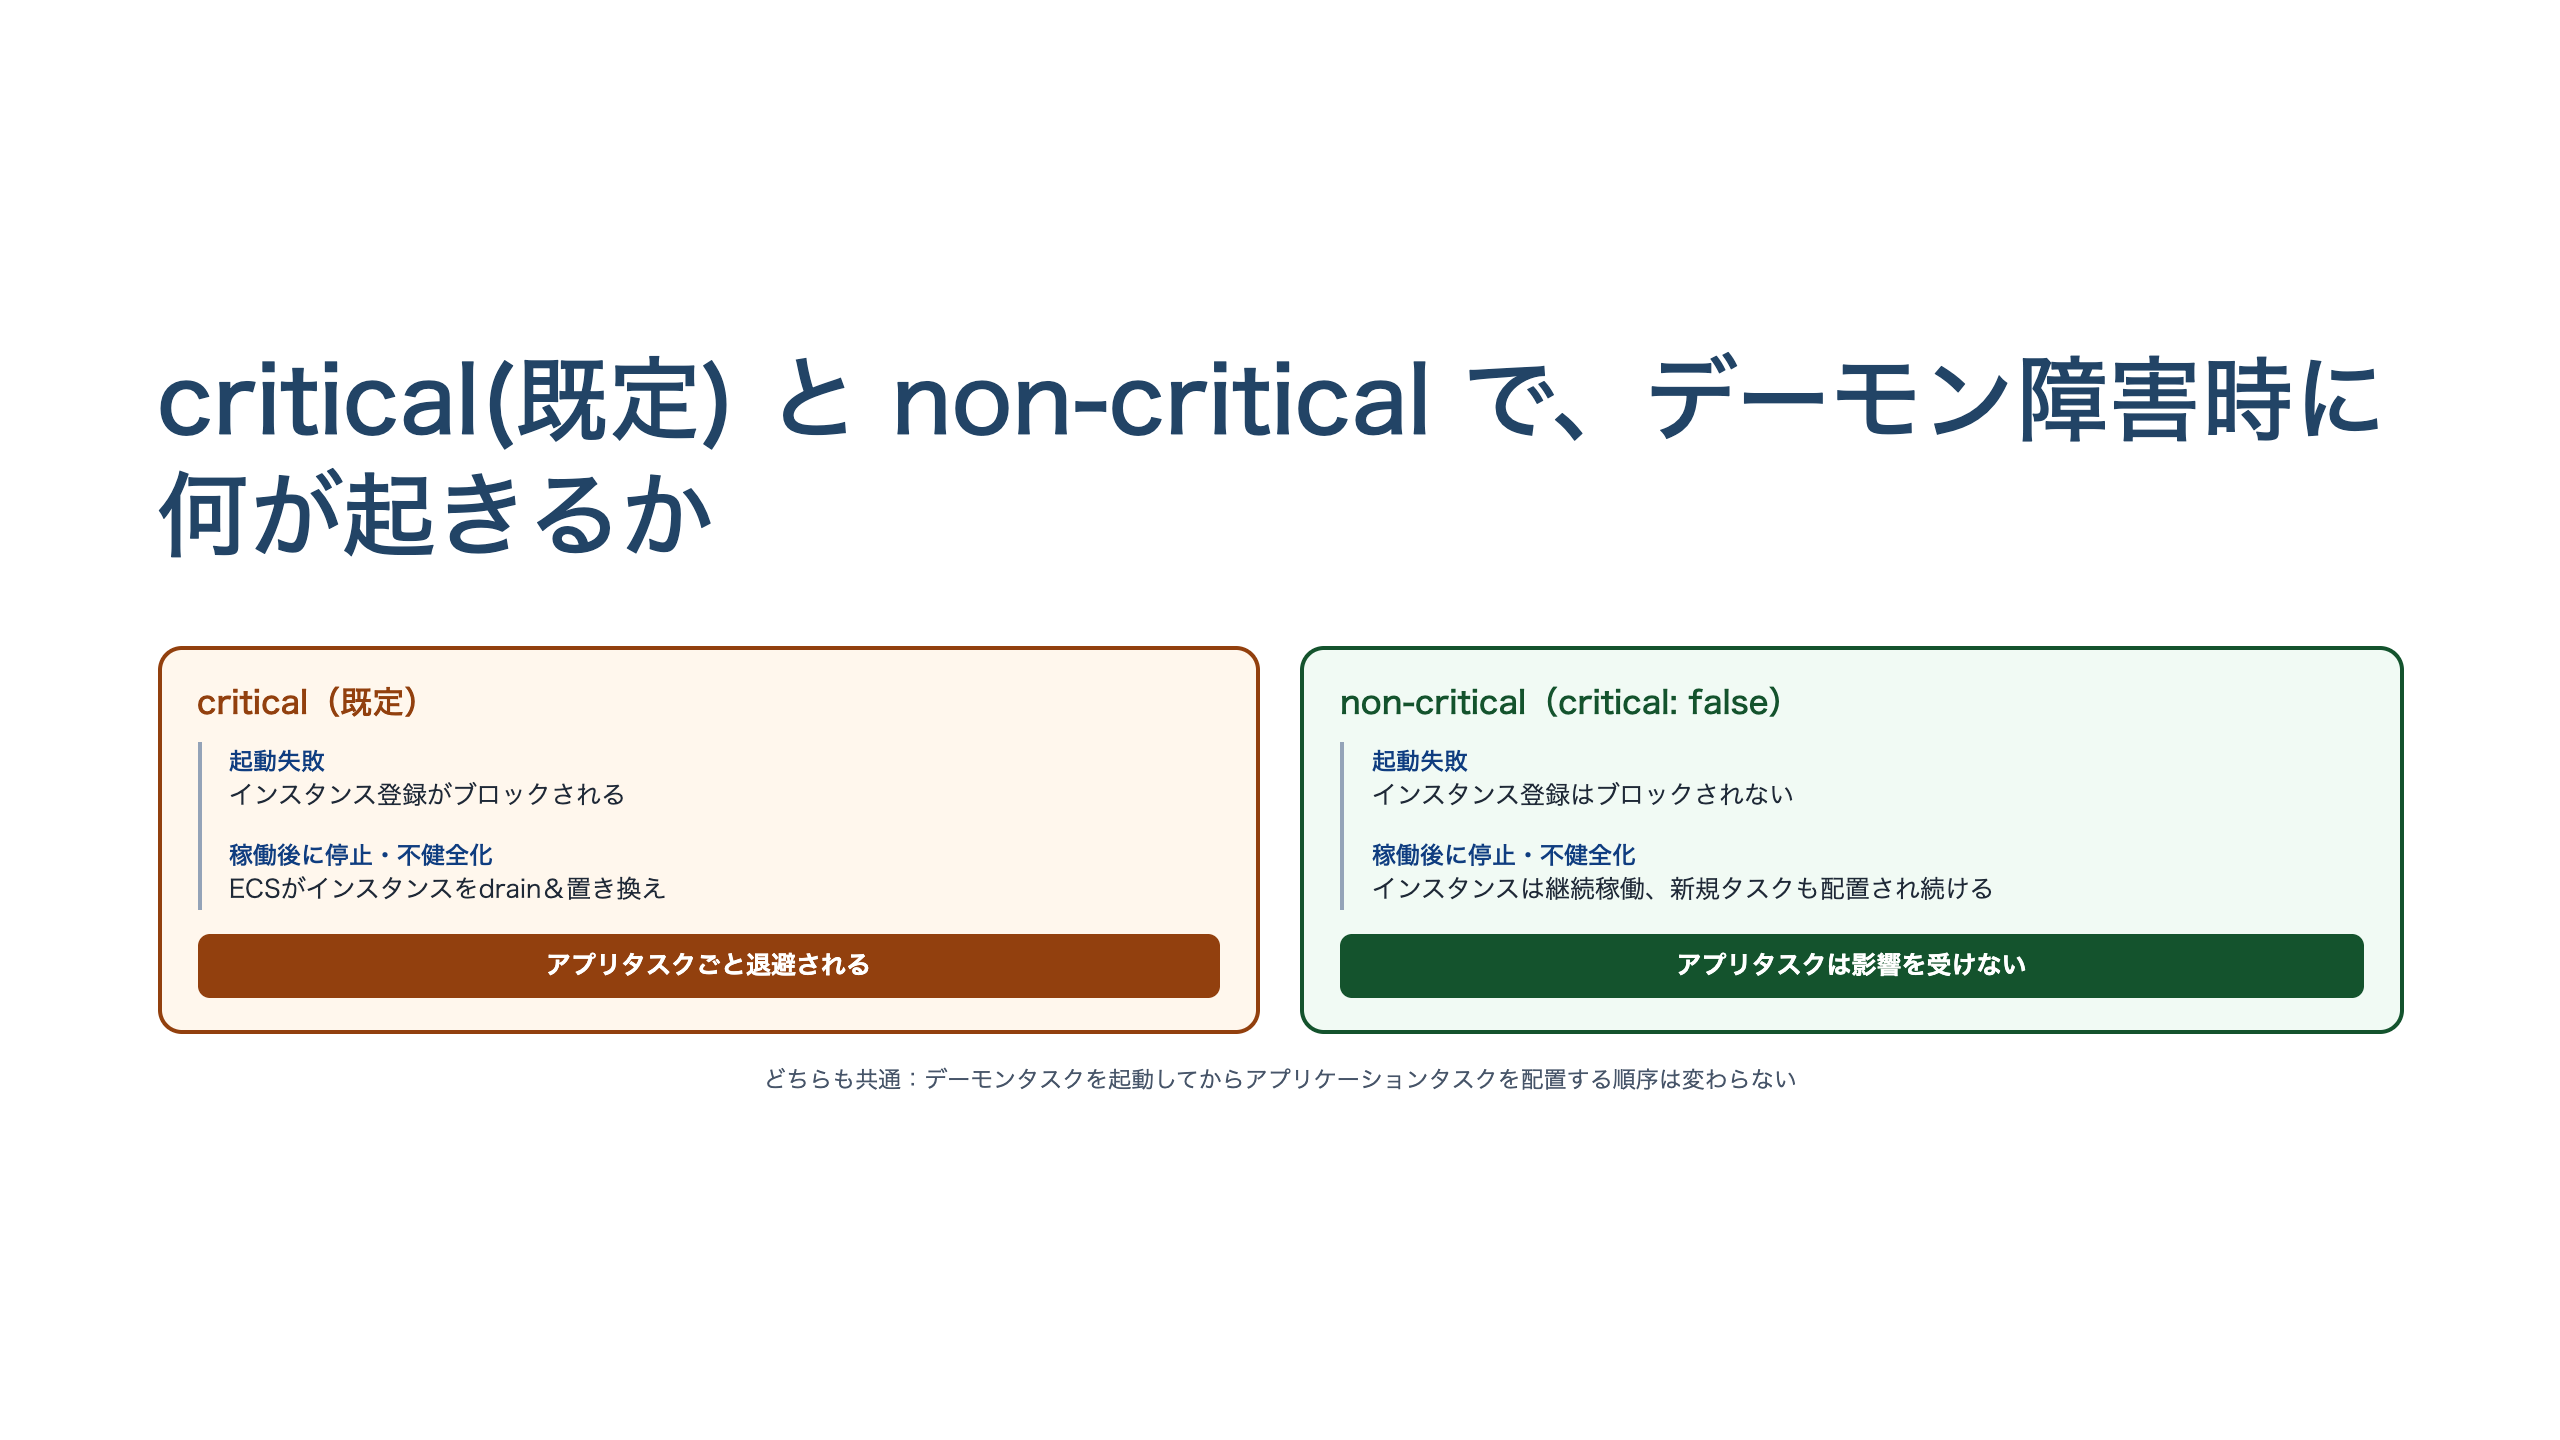
既定(critical、明示しない場合のデフォルト)では、この起動順序に加えて自動修復の仕組みが働きます。デーモンタスクの起動に失敗するとインスタンスは登録されずアクティブになりません。インスタンスがアクティブになった後にデーモンタスクが停止・不健全化すると、ECSはそのコンテナインスタンスをdrain(退避)し、置き換えます。ログ転送エージェントのような補助的な役割のデーモンが不調になっただけでも、アプリケーションタスクごと退避対象になってしまうのがこれまでの挙動でした。
関連する概念 — サイドカー方式との違い
これまでセキュリティ・可観測性のようなエージェントをコンテナ単位で組み込む場合、各タスク定義にサイドカーコンテナとして追加するのが一般的な方法でした。この方式では、同じエージェントの実行イメージがタスクの数だけ重複して動くことになり、クラスター全体で見ると資源のオーバーヘッドが積み上がります。Managed Daemonsはこれに対して、インスタンスごとに1つのデーモンタスクだけを稼働させる方式を取り、エージェントのライフサイクル管理をアプリケーションのデプロイから切り離します。
なお、ECSにはEC2起動タイプのサービス向けに、以前からDAEMONスケジューリング戦略という仕組みが存在します。Managed Daemonsはこれとは別の新しい機能で、ECS Managed Instances向けにデーモンのデプロイを簡素化し、より強いカバレッジ保証を提供するために作られたものです。
仕組み — criticalパラメータで挙動を切り替える
デーモンの作成・更新時にcriticalパラメータをfalseに設定すると、そのデーモンは非クリティカル(non-critical)として扱われます。非クリティカルなデーモンタスクが起動に失敗しても、インスタンス登録はブロックされません。稼働開始後にデーモンタスクが停止・不健全化した場合も、コンテナインスタンスはアクティブなままで、既存のアプリケーションタスクは中断されずに実行を継続し、ECSは新しいアプリケーションタスクもそのインスタンスに配置し続けます。
設定は、AWSマネジメントコンソール、AWS CLI、CloudFormation、AWS SDKのいずれからも行えます。デーモン先行起動というガードレール(アプリタスク開始前にデーモンを起動する仕組み)自体は非クリティカルでも変わらず適用される点に注意してください。変わるのは、あくまで「稼働後にデーモンが壊れたときの対応」です。
設計判断ポイント
- criticalのまま残すか、non-criticalにするかは、デーモンの役割で切り分けます。 ポリシー強制系のセキュリティエージェントのように、不在を業務要件上許容できないデーモンはcriticalのまま維持し、ログ転送・メトリクス収集のように欠落しても即座に業務影響が出ない補助的なデーモンをnon-criticalにする、という考え方が基本になります。
- non-criticalにすると、障害に気づくための仕組みを自分で用意する必要があります。 ECSは、デーモンタスクの起動に失敗した際にEventBridgeイベントを発行し、サービスアクションログにも記録します。これはcritical・non-criticalのどちらのデーモンでも共通です。ただしcriticalであれば、稼働後の停止・不健全化は「インスタンスのdrain&置き換え」という目に見える強いシグナルとして現れます。non-criticalではこのシグナルが無くなるため、EventBridgeイベントやサービスアクションログを自前で監視する仕組みを別途用意しないと、デーモン障害に気づけないまま放置してしまうリスクがあります。挙動を緩めた分だけ、観測性の設計を自分で埋め合わせる必要がある、というトレードオフです。
- デーモンのバージョン更新時のローリングデプロイは、criticality設定とは別の仕組みです。 デーモンを新しいタスク定義リビジョンに更新すると、ECSは関連するキャパシティプロバイダー配下の全インスタンスに対してローリングデプロイを行います。設定可能な割合のインスタンスを同時にdrainしながら更新済みデーモンを持つ置き換えインスタンスをプロビジョニングし、既存のECSサービスタスクも自動的に置き換えます。サーキットブレーカーによる保護が組み込まれており、bake time(様子見期間)とCloudWatchアラームを設定すれば、全インスタニスへの適用後も監視を続け、問題があれば自動的にロールバックできます。この仕組みは
criticalの値に関わらず共通して働くため、混同しないようにしてください。
まとめ
- Amazon ECS Managed Daemonsに、デーモンごとの重要度を指定する
criticalパラメータが追加されました。 - 既定(critical)ではデーモン障害時にインスタンスごとdrain&置き換えされますが、
critical: falseにするとインスタンスは継続稼働し、アプリケーションタスクへの影響を避けられます。 - ただし障害の自動シグナルが消えるため、EventBridgeイベントやサービスアクションログを使った監視を自前で設計する必要があります。
出典
- Amazon ECS Managed Daemons now supports non-critical daemons(What’s New。発表日2026年9月3日。
criticalパラメータの設定方法、non-critical時の挙動、設定手段、EventBridgeイベント・サービスアクションログへの言及を記載) - Amazon ECS Managed Daemons - Amazon ECS Developer Guide(「Daemon criticality」節にcritical/non-criticalそれぞれの挙動、初回起動順序、ローリングデプロイの仕組みを記載)
- Introducing Amazon ECS Managed Daemons(Managed Daemons自体の初出発表。発表日2026年4月1日)
For Freelancers
インフラ設計・構築の案件を募集しています
この記事の技術に近い、いま募集中の業務委託案件です。
インフラ設計・構築の記事
すべて見る →-
技術記事 · インフラ設計・構築 · 2026/11/11
Lambda の Kafka 連携に「キューモード」ができた — 順序保証を手放して並列度を取る前に決めておくこと
-
技術記事 · インフラ設計・構築 · 2026/9/10
S3のFIPS対応がPrivateLinkだけで完結するようになった — 専用エンドポイントとDNS設計の要点
-
AWS障害 · インフラ設計・構築 · 2026/8/12
マルチAZ設計は、その一本の回線を守ってくれない — 2021年9月 東京リージョン Direct Connect障害に学ぶ
-
技術記事 · インフラ設計・構築 · 2026/8/9
ECS Service ConnectのAZ優先ルーティングがデフォルト化 — エンドポイントがAZ数の2倍を割ると静かに均等配信へ戻る